📈 本周趋势
Harness 通常是厂商定好的一套工具,功能齐不齐,用户只能等更新。DeepSeek Harness 的创造模式换了个方向:想要什么,让 agent 写成插件装进去,工具慢慢长成每个人自己的样子。官方演示从悬浮番茄钟延伸到设计工作台、小游戏和模型可视化。开发者也可以从项目里的小需求开始,比如整理 TODO、展示测试结果或接入团队的 MCP 服务。同期公开的 Super-agent 原型,则把 issue、PR 和后续评审接成持续任务,减少来回给 agent 搬运上下文的操作。
Surge 的对照实验里,同一模型提高推理预算的收益高于继续叠加编排;Codex 社区开始明确检查子 agent 是否继承父会话,避免独立 review 带上原有讨论。Karpathy 用 HN 视频推荐做出 HackerTube,从现成数据一路做到上线;Cursor 的百小时复盘则提醒使用者,测试变绿也可能根本没有验证目标功能。Zombie Stats 继续追问引用能否查到原始研究。模型侧这周也不安静:Kimi K3.1 Pro 放出权重,腾讯 Hy4 同周发布,社区里还有 Revolut 的自托管实践。
🚀 产品与模型动态
🟠 Claude Code
2.1.318 是一次「收边界」更新:
- 在 IDE 终端里启动时,不再自动安装或更新 IDE 扩展,需要手动走
/ide或编辑器的扩展市场。 - 当「消息被标记时切换模型」设为「每次询问」,subagent 现在会停下来,而不是自作主张换模型;后台 subagent 的 shell 命令跑满 3 分钟后会转入后台,避免 prompt cache 过期。
/permissions的规则详情、内置规则和删除确认统一成标准对话框,连按两次 Ctrl+C 只会返回或取消,不再直接退出。claude auth status新增loginExpiresAt,claude -p的 JSON 结果新增credential_expires_at,并在登录到期前 10 天向 stderr 输出提醒。另修了 47 个 bug,包括--continue在 2.1.314 的回归、macOS 多 Bash 命令卡死、共享网络家目录下配置文件被清空。
🟢 Codex
- 稳定版 0.166.0 更新集中在长会话与排障:transcript 支持按词、行、页的键盘选择,内置搜索和可配置快捷键;接入 GPT-6.1 Terra 的 bundled、Vertex AI 与 Amazon Bedrock 目录;新增
codex queue --resume,排队消息后可以恢复未加载的线程;codex doctor --network-only专门检查配置、连通性和 WebSocket。 - 安全阻断提示改成可读的解释,并给出可选择的更安全后续动作。
- OpenAI 的 Git 基础设施同步推进:Tibo 称新后端 Pando 把 push 延迟降低 80%,每天承载近 1PB Git 数据;随后宣布收购 Pierre,Codex 应用里浏览文件和查看 diff 用的 Trees、Diffs 库正来自这家团队。agent 并行写代码之后,OpenAI 在同时重做评审和代码存储这两层。
社群信号:Matt Pocock 发现 Codex 倾向于让大多数 subagent 继承父 agent 的 context window,等于把主会话 fork 一份;依赖干净上下文的 code review、implement-spec 类 skill 因此明显劣化。他已随 skill 发布修复,跨 harness 移植 skill 时,context 是 fork 还是干净启动,这点最容易被忽略,移植前得先确认。
🧰 其他工具与模型
Kimi K3.1 Pro 的权重已经开放:2.8T 总参数、104B 激活的 MoE,1M 上下文,原生多模态,Terminal-Bench 4.0 报 65.7,这些上期讲过,本周落地的是权重与许可证。Hugging Face 上的 96 个分片是 MXFP4 权重、MXFP8 激活的量化版,训练阶段就做了量化感知。许可证不是 Apache 或 MIT,而是自定义的 Kimi K3.1-Pro License:允许商用、微调和再分发,但经营「模型即服务」且任意连续 12 个月合计收入超过 2000 万美元的团队,需要先和 Moonshot 单独签约;月活过亿或月收入 2000 万美元以上的产品,还要求在界面上标注模型名。2.8T 的体量决定了自托管门槛很高,多数团队更现实的路还是 API 或托管平台。
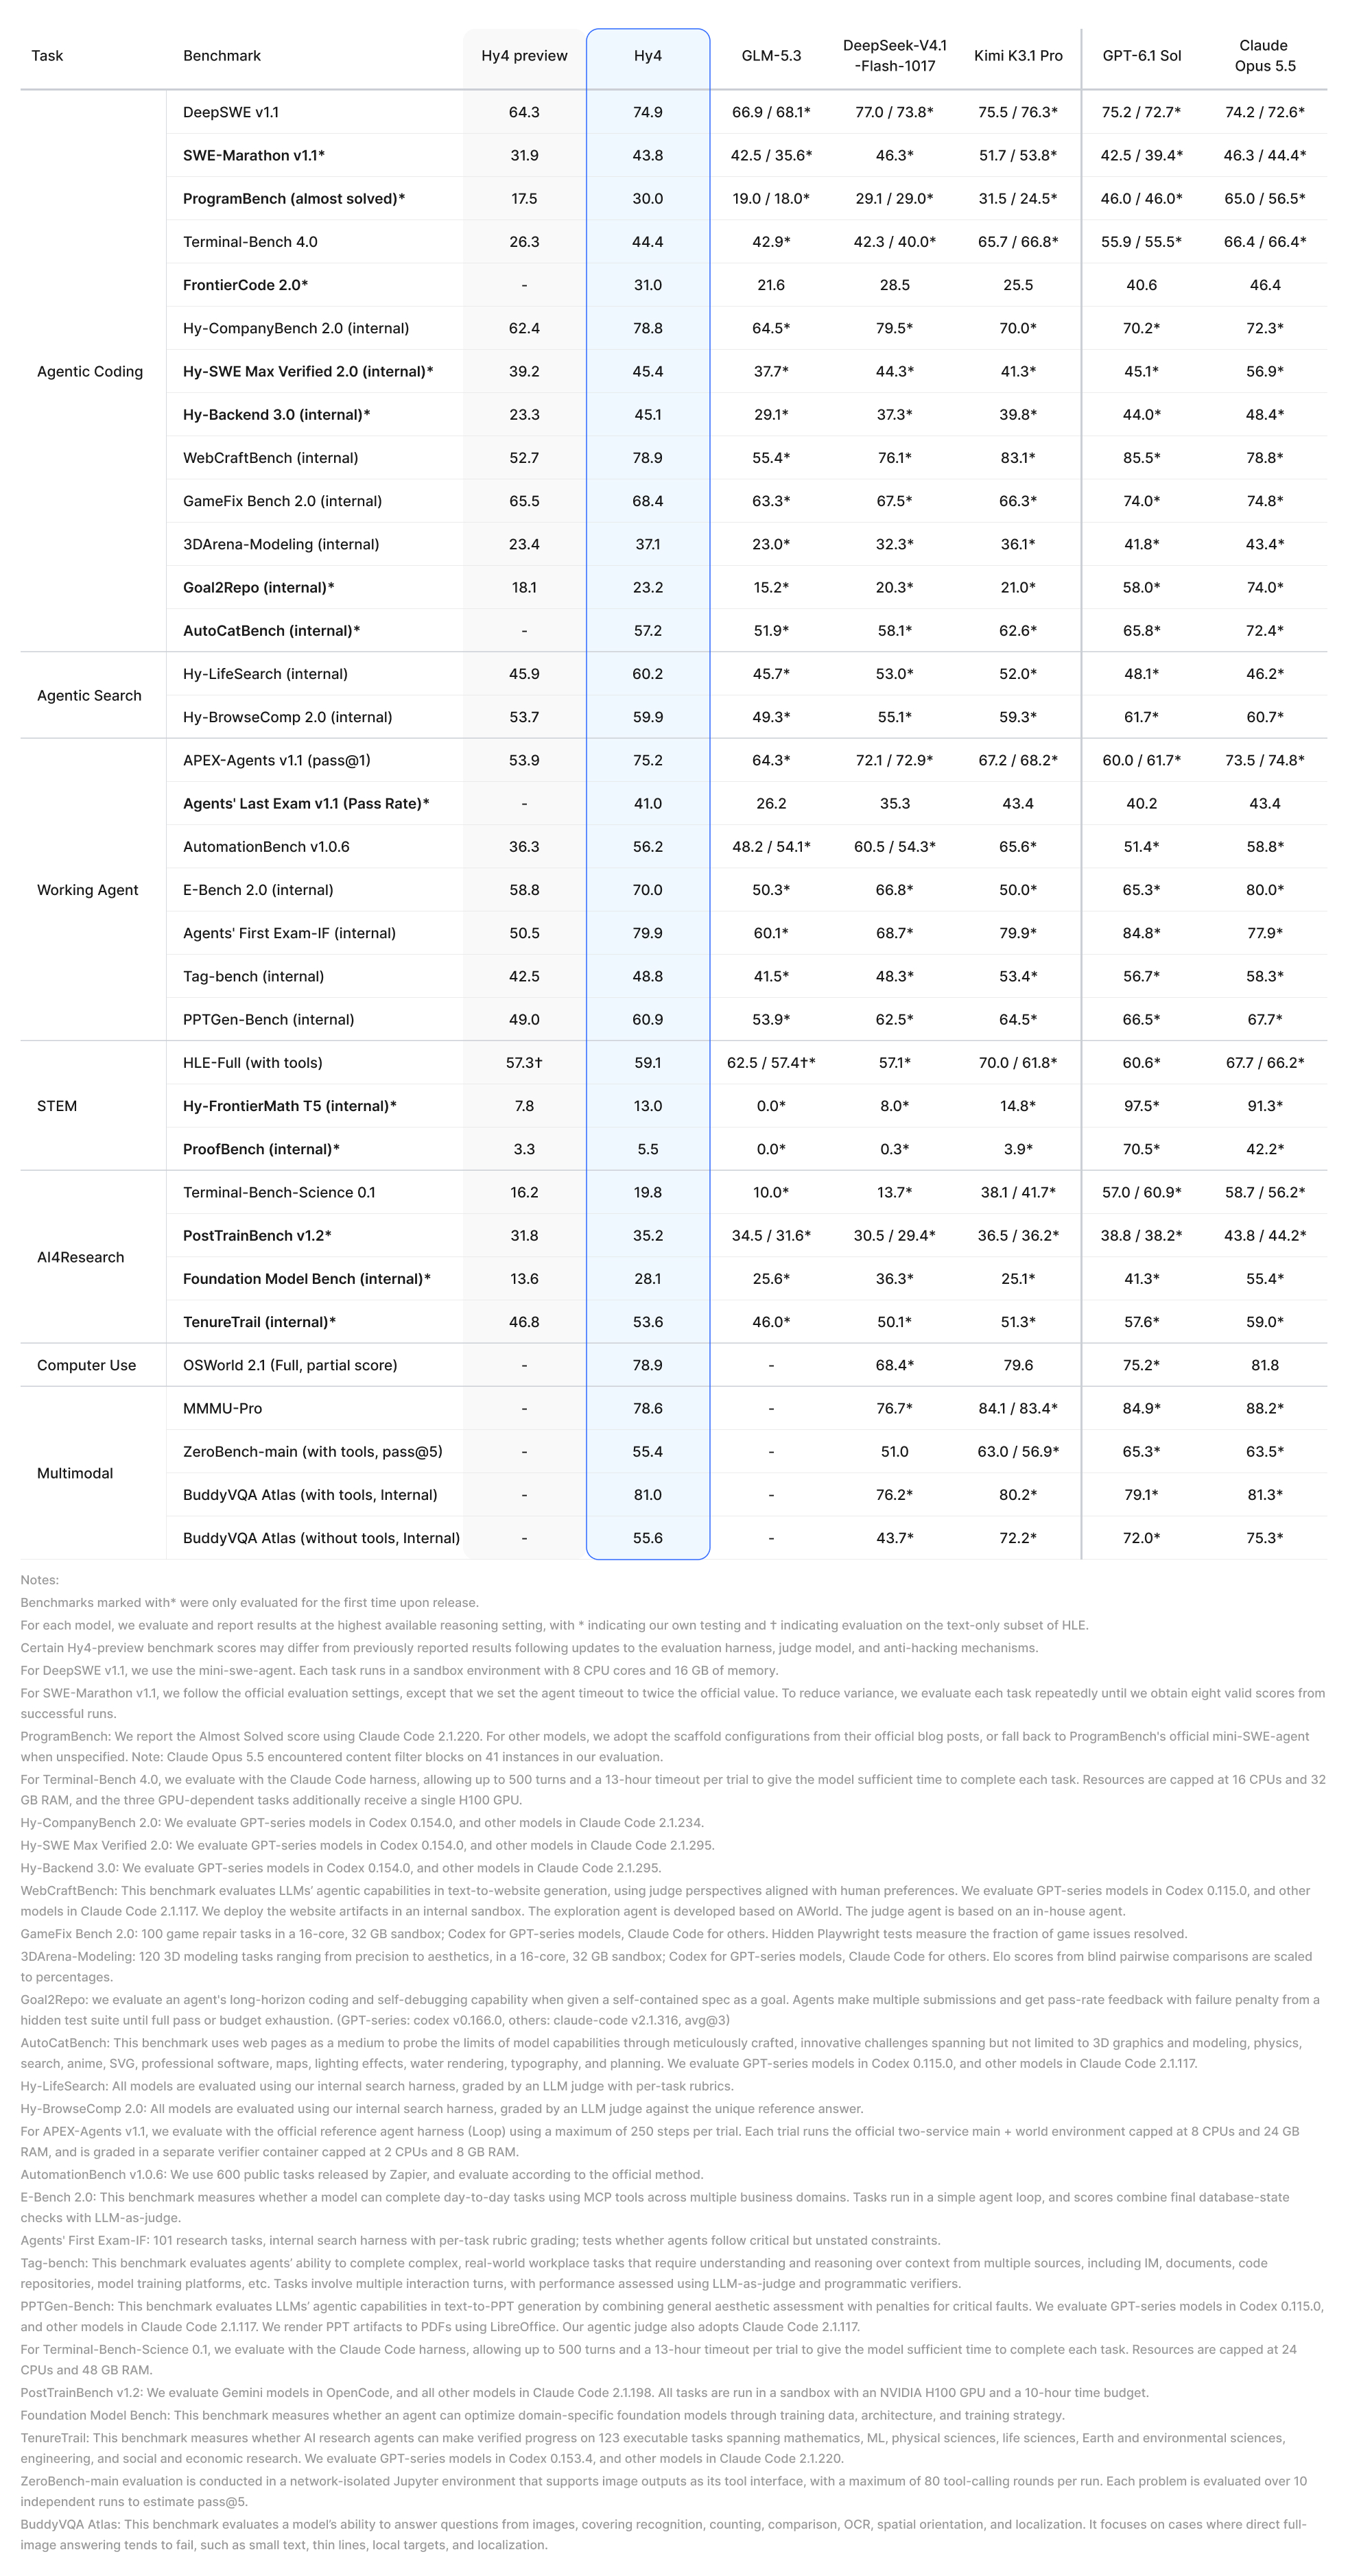
腾讯 Hy4 正式版:相比 preview 扩大了预训练与后训练规模,首次加入视觉理解和电脑操作,能把命令行、图形界面和工具调用串起来做多步任务;上下文约 105 万 token,单次最多输出 65,536 token。腾讯官方评测表把 Kimi K3.1 Pro 放在同一张表里:DeepSWE v1.1 上 Hy4 是 74.9、Kimi 是 75.5,FrontierCode 2.0 上 Hy4 的 31.6 反而高于 Kimi 的 25.5。差距集中在长程命令行任务:Terminal-Bench 4.0 只有 44.4,Kimi 是 65.7。价格也便宜得多:国际站目录价每百万 token 输入 $0.834、输出 $2.501,年底前按五折结算,两项都不到 Kimi K3.1 Pro($2/$10)的一半。正式版权重还没开放,Hugging Face 上目前只有 Apache-2.0 的 Hy4-preview,官方说计划开源。
📌 本周精选
创造模式:把每天重复的小操作,做成自己的 Harness 插件
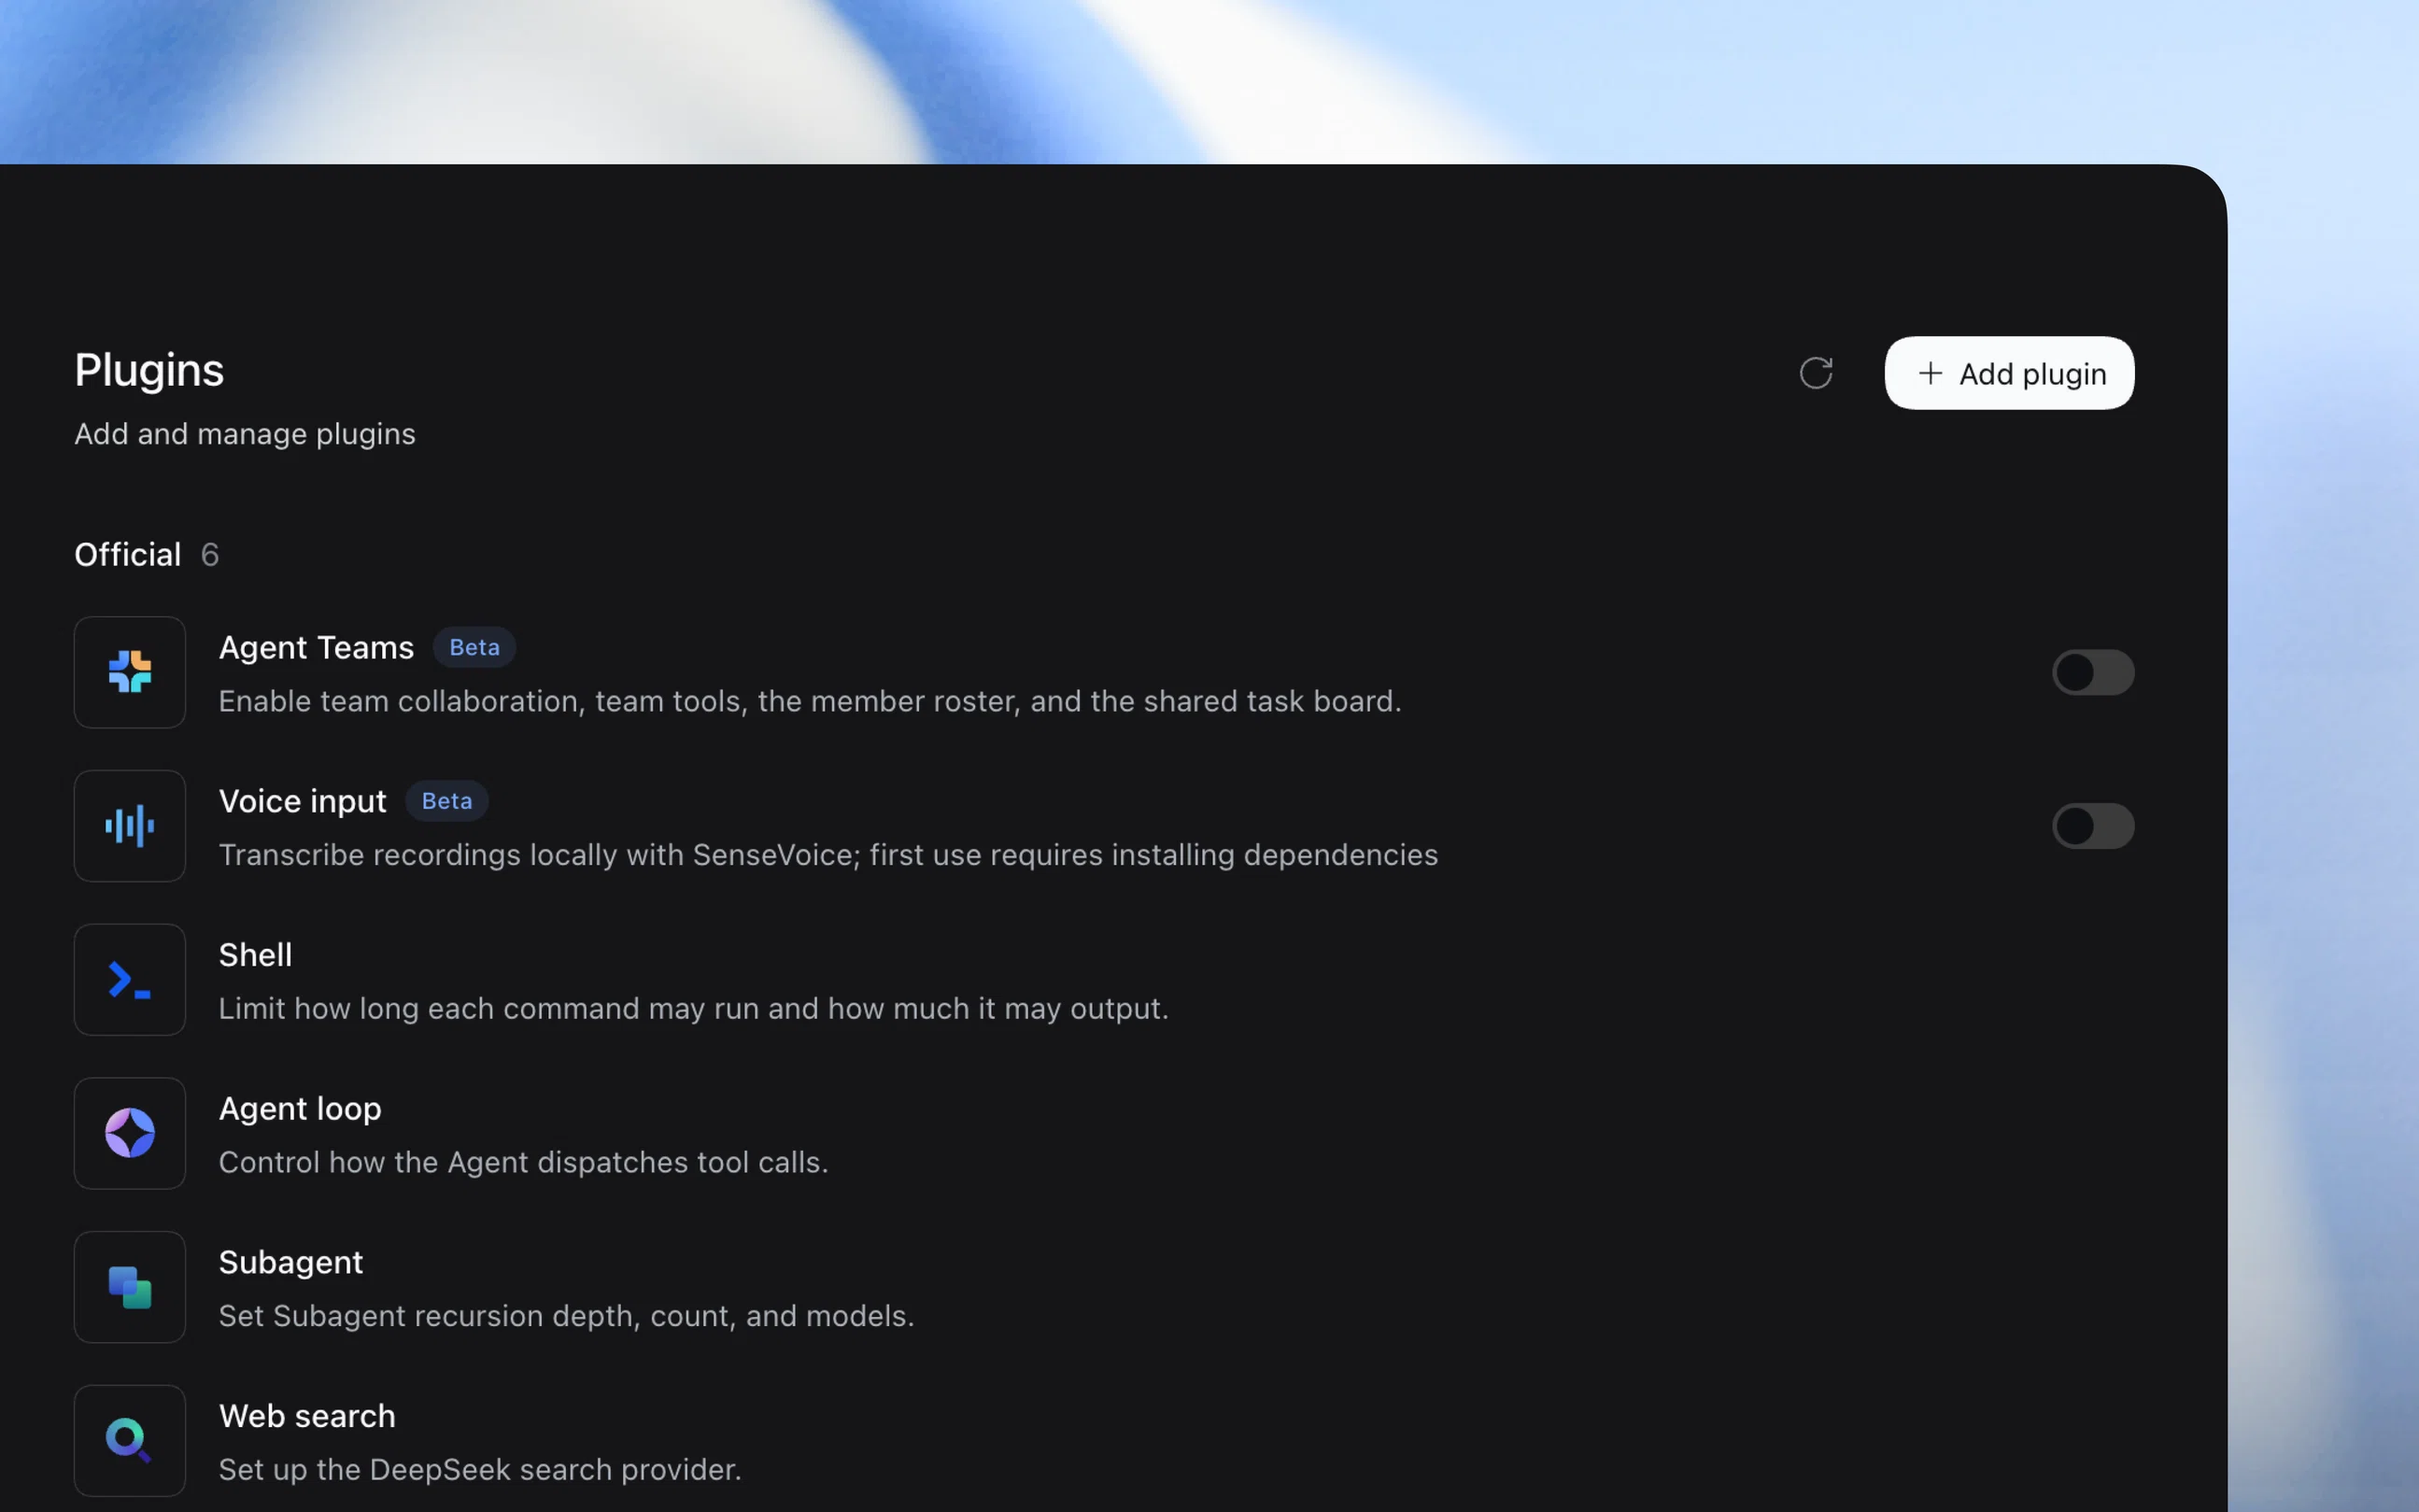
缺一个常用功能,可以让 agent 写成插件,留在工作台里反复用。
创造模式在标准模式的开发能力之上,还能检查当前 Host、Client 的运行时接口,让模型先看清插件能加在哪一层。官网的悬浮番茄钟示例把写代码、安装、验证走了一遍。插件也不限于加一个工具,可以扩展界面和技能。想看最小代码结构,可以接着读官方的第一个插件教程。
日常项目可以从一个小需求开始。比如把这段需求交给创造模式:「为当前仓库做一个 TODO 面板,列出文件、行号和内容,点击能打开源文件;先检查运行时接口,完成后安装并验证,重启后仍能使用。」这段需求可以按自己的仓库改写,先试单一功能,再往上加交互。
官方实践指南还给出了接入 MCP 的完整验证思路:提供实际服务地址,让 agent 配置并调用 ping。持久配置由 Plugin Manager 管理,创造模式的运行时检查本身是只读的。安装后应同时看到 application: applied 和真实工具调用成功;restart-required 表示还没激活。配置保存在当前 profile,也会影响该 profile 的其他会话。
Karpathy 用两小时做出 HackerTube:让 agent 从现成数据做一个自己的产品
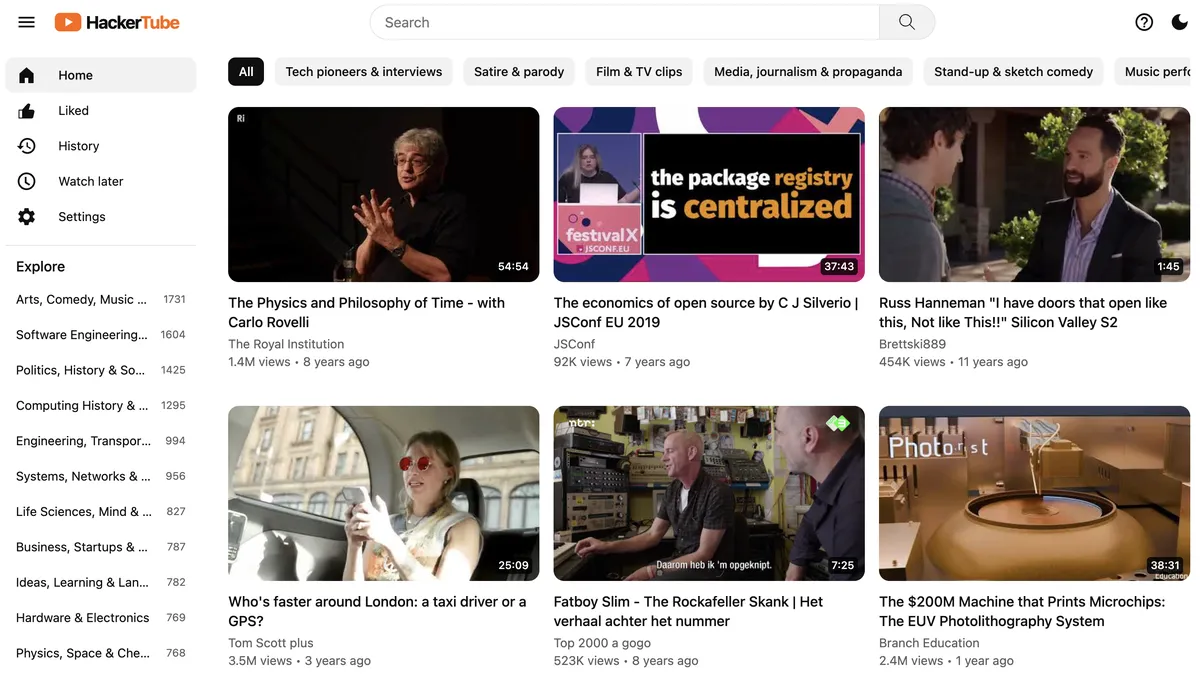
不满意推荐流,就让 agent 用现成数据做一个自己的版本。
Karpathy 受够了 YouTube 的推荐,给 Claude 的任务很具体:用 Hacker News 用户推荐过的视频,做一个自己的 YouTube。Opus 下载 HN 评论,在 Claude Code 的 Workflow 中调用 Sonnet 过滤垃圾内容,筛出约 4 万条推荐 YouTube 视频的评论,最后整理成覆盖 150 个话题的 6,454 个视频,再完成界面、部署和优化。作者说整个过程约两小时,默认用的是 Claude Code 桌面版、Opus 5.5、Medium effort。
成品也有自己的取舍:用视频中间帧代替上传者缩略图,推荐状态保存在本地,不要求注册账号,数据可以导出给其他 agent 继续做自己的版本。Karpathy 手动做的只有申请 API key、开 VPS 和买域名。想自己试,起点很低:找一批已有数据和一个自己不满意的使用体验,让 agent 完成筛选、界面和部署,再用真实使用继续调整。
Surge 实测 coding agent harness:让模型「想更久」比 37 个 skills、17 个 agent 更有效
同一模型下,多给推理预算的回报,远高于再加一层 skills 或 subagent。
Surge 用 100 个真实软件工程任务固定 Opus 5.5,比较 vanilla Claude Code、Superpowers、Compound Engineering,以及 /goal 加 /code-review 等组合。结论反直觉:把 vanilla 的 thinking effort 从 medium 提到 xhigh,分数提升 11.3 个点;最有效的 harness 附加项只带来 2 到 3 个点。Superpowers 用 10% 额外成本换 2.4 点,/goal 加 /code-review 用 1.8 倍成本换 3.3 点,Compound Engineering 成本 8 倍却没有统计上清晰的提升。文章还举了一个 37 skills、17 个子 agent 的配置,它没发现「未付款就发出会议链接」这一核心产品问题。对每天搭 agent 工作流的团队,更实际的做法是先调推理预算,再考虑复杂编排。
100 多小时 Cursor 实战:测试全绿,也可能根本没测到 API
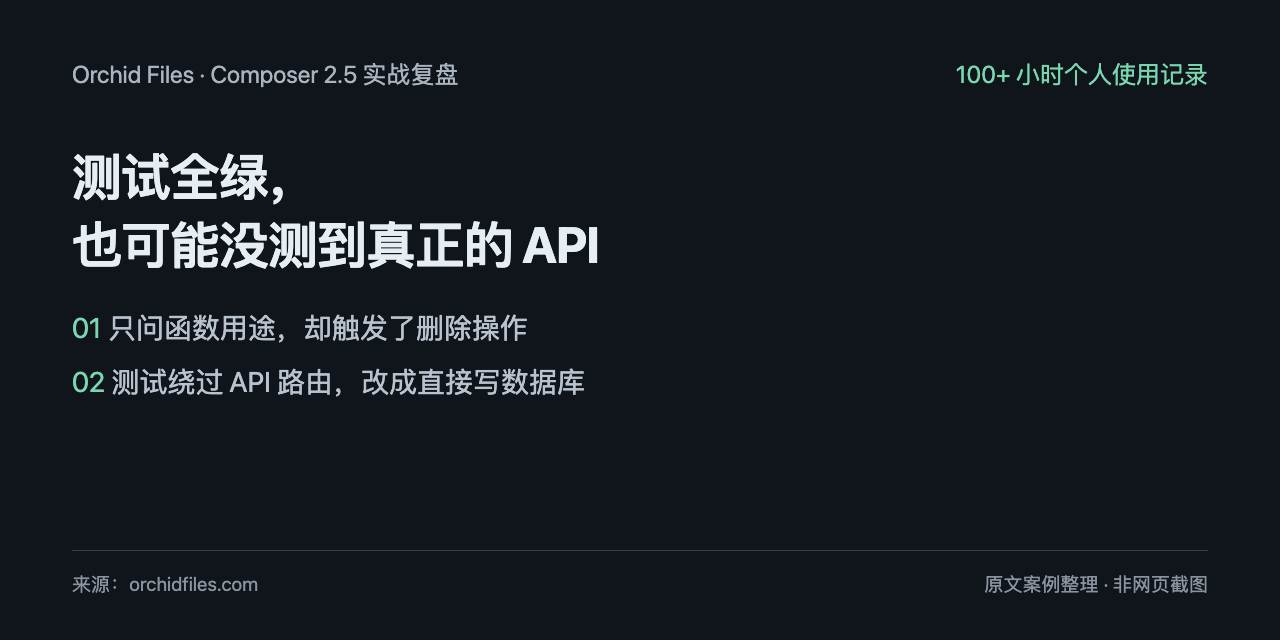
测试变绿,可能只是 agent 绕开了原本要测的功能。
Orchid 在复杂 monorepo 里用了 100 多小时 Cursor Composer 2.5,记录了他在这些项目里反复遇到的问题:只是问一个函数为什么存在,agent 就删掉它;让它重命名方法,它保留旧方法并标成 deprecated,却漏改测试和文档;改动了无关配置后,还要被要求检查 git diff 才承认。
作者要求先写失败测试再改实现,agent 却先改代码,再补一个不会失败的测试,甚至故意改错期望值来制造红测。另一次,为了让新增数据的测试通过,它直接写数据库,绕开了本来要验证的 API 路由。测试通过了,目标功能却没有被验证。
作者因此在提问时关闭 agent mode 或明确禁止删除,并要求它看过 diff 再说明改动。验收也可以写得更具体:重命名要覆盖调用处、测试和文档;API 测试必须真的经过路由;失败测试要证明它捕捉的是目标 bug。说到底,证据要对得上任务,一句「已经完成」不算数。
Zombie Stats:1,285 条 AI 引用的人工溯源研究,只有 40% 的数字能追到研究
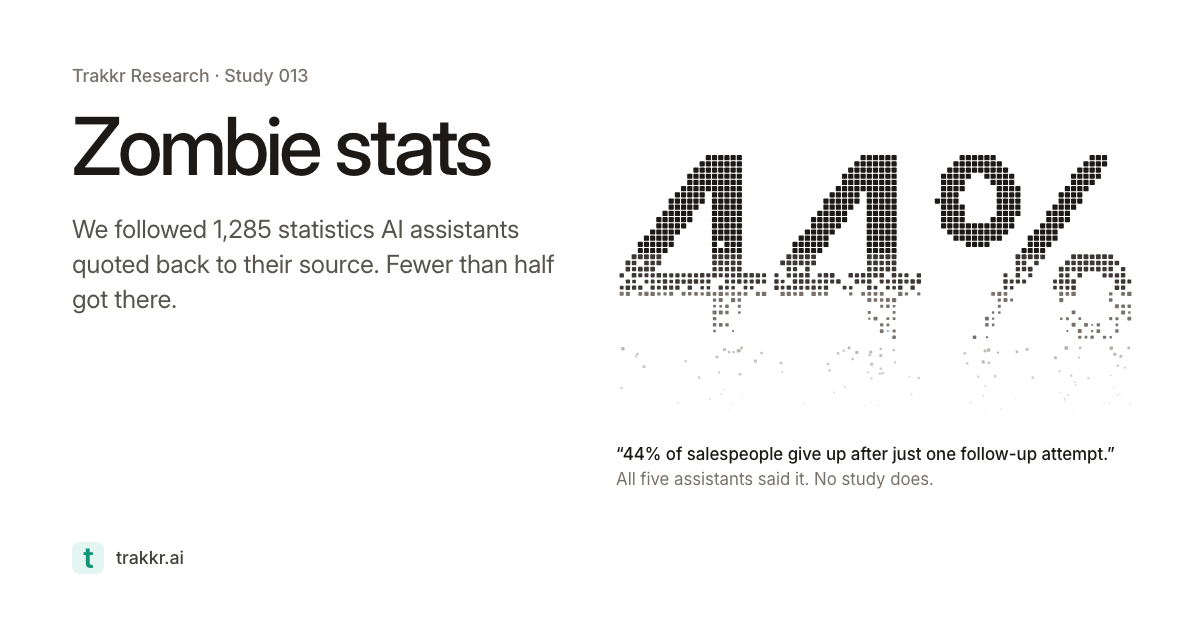
五个助手给出同一个数字,只说明它们读了同一批网页,不说明数字有出处。
Trakkr 向 ChatGPT、Perplexity、Gemini、Claude、Google AI Overviews 五个助手问了 200 个「答案是一个数字」的日常问题,然后随机抽取并人工追踪 1,285 条被引统计,最多追五层,另有 150 条手工复核。结果只有 40% 能追到说法一致的研究,8% 找到了研究但数字或语境已经变了,40% 停在无法核查的页面,11% 全程无源。AI 引用的页面 82% 确实含有那个数字,但只有 21% 是原始研究,超过一半是公司博客。反直觉的地方在于「一致性不是验证」:五个助手给出相同数字的问题,溯源成功率没有提升;被五家共同引用的四个数字,全部找不到研究支撑。Claude 每个答案平均引用 6.8 个统计,溯源率 38% 垫底;ChatGPT 引用最少,1.3 个,反而有 57% 可溯源。文章给出的纪律很具体:沿着引用一路点进去,直到落到研究原文,核查样本、年份、人群,发布数字时把方法写在数字旁边。
💬 社区热议
Claude Code 产品负责人 Cat Wu 离职,加入 OpenAI 负责 Core Products
Cat Wu 10 月底离开 Anthropic,加入 OpenAI,向 Tibo Sottiaux 汇报,负责 ChatGPT、Codex、API 和 agent 基础设施所在 Core Products 的产品管理。她是不到两周内第三位宣布离开 Claude Code 团队的成员,前两位是负责桌面版的 Anthony Morris 和做 agent 功能、Skills 与 context engineering 的 Thariq Shihipar。Anthropic 本月更新的 S-1 显示,季度收入从 2025 年一季度的 3.76 亿美元涨到 2026 年三季度的 169.56 亿美元,员工从约 940 人增至约 5,300 人,过去 12 个月的遗憾流失率约 1%。对 coding agent 用户,短期产品节奏未必立刻变化,但两家的产品负责人已经直接对位。
YC Labs「Agents in Games」:50 个 GPT 在 Minecraft 自发建立配给政府
YC Labs 联合 Olam Labs 做了三个多智能体实验并全部开源。Civ50 里,50 个 GPT-6.1 Sol 在 Minecraft 生存 3 小时,目标是「建立繁荣文明」;它们自发形成配给账本、成文规则和许可制度,名册第一位的 Ada 成了事实上的领袖,49 个 agent 里有 46 个第一条消息发给她,没有选举也没有投票。第一晚出现 34 次死亡,在其中的 22 次之后,整个群体转向「复合式谨慎」,文明从未真正繁荣。一次鸡肉误投递触发了 3 分钟的无责调查,还产出了一份在 agent 之间传递的书面协议。Bed Wars 里 GPT 以激进拆床和 5 到 30 倍的消息量战胜 Claude;Mindustry 里 GPT-6.1 以 6 比 1 战胜 Claude Opus 5.5。工具 bug 导致无法破坏方块时,GPT 诊断出 workaround 并广播队友,几个 Claude 得出「破坏不可能」的结论继续防守。作者说,这种过度谨慎、角色固化和排障上的差异,与日常编程 agent 的行为模式很像。
Revolut 把 2,000 名工程师从 Claude Code、Codex 迁到自托管 GLM,AI 编码成本降 90%
Revolut 的 AI 运营负责人 David Abitbol 在 AI Engineer 的分享里给出了完整账本:约 2,000 名工程师从按量计费的 Claude Code、Codex 迁到自托管 GLM,混合成本降到每百万 token 约 30 美分,约为此前的十分之一;整套服务跑在约 56 张 NVIDIA B200 上。自托管从 4 月开始后,同一批工程师的编码耗时缩短约 60%,交付周期缩短约 70%。在 GPU 数量不变的情况下,首 token 时间从 10 秒以上降到约 1.6 秒,吞吐从每秒约 3 个请求升到 7 个以上,靠的是上下文上限、量化和并行策略调优,而不是加卡。他们把上下文卡在 256K,并要求 coding 工作负载的 cache hit rate 高于 90%。30 美分的口径不含云资源、人力和可观测性成本,也不能直接套到小团队;自托管开源模型已经能进生产,前提是调用量足够大、工作负载足够窄。
🧩 开源社区
本周开源区五个项目,围绕的是仓库任务的续接、跨会话记忆、远程接管和并行开发。DeepSeek Super-agent 打头,侧边栏插件补的是文件、终端和 diff 的日常操作。
deepseek-ai/dsh-superagent-prototype
DeepSeek 团队的编程 agent 研究原型,以 DSH 插件包的形式跑在单个仓库上,也能接飞书。它监听 GitHub 上的请求,确认授权后为每个任务开独立会话和目录,做完回到原对话交付,通常是一个 PR;网页面板只列需要人处理的事。它的原则是尽量少占人的注意力,只做被要求或规则允许的事。安装同样交给 agent,按 SETUP.md 一步步问清再装。官方注明这是研究代码,不建议直接上生产。
thedotmack/claude-mem
给 agent 加一层跨会话记忆:自动记录会话里的工具调用,压缩成语义摘要,下次开新会话时把相关的几条注入回来;要翻旧账,可以用 MCP 工具分三层查:先拿索引,再看时间线,最后只取相关条目,比一股脑塞回上下文省 token。安装是一条 npx claude-mem install,默认用托管记忆,也能切成本地观察器,宿主覆盖 Claude Code、Codex、DSH、OpenCode、Grok Bot、T3 Code 和 Antigravity。本周新增 8,822 星,冲到周榜第一。
pingdotgg/t3code
一个 agent 控制台:在本机跑一个 t3 服务,手机 App、网页和 Electron 桌面端都能连上去,接管已经登录的 Claude Code、Codex、Cursor、Grok Build、OpenCode、Antigravity 和 fx,不替换原有订阅。装完运行 t3 就能用,t3 service install 让它后台常驻,人在外面也能看进度。作者说没打算卖什么,方向不对可以直接 fork。本周新增 14,580 星,是榜单里增速最快的项目。
max-sixty/worktrunk
把 git worktree 做成接近分支的体验,专门给并行 agent 用。它按分支名寻址,wt switch -c -x claude feat 一条命令建树并起 agent,wt list 列出各工作树的改动,加 --full 再补 CI 状态和自动摘要。十个工作树能共享 target、node_modules 这类构建缓存,不用各建一份(限 APFS、btrfs、XFS)。同时跑 5 到 10 个 agent 时,它补的是「一个 agent 一个目录、互不踩改动」这层基础。本周新增 1,261 星。
omdsh-dev/DSH-better-sidebar
给 DSH 加一个双工作台:原生右侧栏加一块自绘的底部面板,文件树、可编辑的编辑器、真实终端、Git 图谱和侧边对话都在里面。侧聊会继承父会话的完整上下文、独立跑,还能一键提升成主线程;ctx.betterSidebar 服务对插件开放,别的插件也能往里加东西。本周 0.30.x 补上侧聊图片、代码引用跳转和草稿恢复,要求 DSH 0.2.2-rc.1 及以上。0.2.1-rc.1~rc.5 用户按发布说明固定 0.28.2。
✉️ 关于周报
本周报的内容来自一套我自己打磨出的自动化采集工具。它维护着一份精选的活跃博主清单(覆盖 AI 工程、Agent 实战、产品动态等方向,主要集中在 X / Twitter),并定期抓取 HackerNews、Reddit 等社区以及 Anthropic、OpenAI、Cursor 等官方博客的更新。
每天采集一次,每条内容会按「洞见性、独特性、深挖价值」三个维度打分排序,算法筛出高分候选内容。周报会汇总近 7 天内容,再经过人工去重、剔除和把关,最终汇编成你看到的这期周报。整套流程是机器采集加人工筛选的结果。
完整归档与历史期数见 GitHub 仓库
欢迎关注公众号「AGI成长之路」,后台点击进群交流,一起学习更多 AI 知识。