📈 本周趋势
AWS 用 Agent 写了一套覆盖 200 多项服务的本地模拟器。工程师定好验收流程,让 Agent 用真实 AWS 校验测试、复现差异,再把问题交给另一组 Agent 修。换到自己的代码库,合并前可以查三件事。
- 结果符合验收条件吗? 对照需求看具体行为。修的是重试逻辑,就核对什么情况下该重试、最多几次,以及重试用完后该返回什么。
- 测试结果能重跑吗? 看 PR 有没有给出输入、命令和运行结果。修 bug 时,用同一个回归用例确认旧版会失败、改完后能通过。
- 有人独立审过代码和测试吗? 让没参与实现的审查者看 diff,核对有没有超出需求、断言有没有被放宽,还有哪些边界没测到。合并前把这些问题交给负责人确认。
这三项也能直接用来交接。把验收条件、可重跑的命令和审查结论留在 PR 里,接手的人能直接看到上次验证到了哪一步。Anthropic 的记忆实验把会话日志、笔记、Wiki 和启动时注入的规则分开,Cursor Projects 则让需求、任务和 PR 在同一个共享工作区里可见。遇到疑问再回查会话,已经反复验证、下一次还用得上的约定,再写进项目指令。
🚀 产品与模型动态
🟠 Claude Code
- 2.1.319 会在后台运行支持任务模式的 MCP 工具,完成后再交回结果。设置
permissions.denyInsteadOfPrompting后,原本需要交互确认的调用会被拒绝,适合无人值守的终端会话、子代理和队友。 - 2.1.321 支持
claude remote-control --settings <file>,每个由它启动的会话都会应用同一份设置。Apple 也把 Xcode 插件入口 合入了 Claude Code 官方插件市场,入口指向 Xcode 自带的插件。
🟢 Codex
- CLI 0.167.0 的
codex agents --no-daemon可以打开 Agent 控制台,控制台和会话选择器会标出未读结果。切换已连接的后端可以保留输入草稿,支持的终端还可在发送前预览本地图片附件。 - CLI 0.167.2 给 Google Cloud Vertex AI 默认启用增量工具更新。需要沿用旧行为时,可在
[features]中设置incremental_tools_legacy_gcp = false。 - Codex Security 0.10.0 可以继续中断的 Standard 扫描,并为批量扫描设置共享预算。补丁生成受阻时会报告已经做的改动和下一步。
- Codex 负责人 Thibault Sottiaux 回应了 Pro 用户对额度的疑问。Pro 100、200、500 在 Work 和 Codex 中均无 5 小时上限,仍受周额度约束。
🧰 其他工具
- Cursor Projects 开放多人协作。队友保留各自与协调 Agent 的对话,共享任务板、需求文档和项目上下文。交接 on-call 时,接手方的 Agent 可以读取未完成的任务和事件记录。共享项目需要团队账号和 Cursor 3.26.13 或更新版本。
🧠 模型动态
Claude Fable 5.2 更新了复杂编码、推理和视觉能力。Anthropic 公布的 FrontierCode 2.0 对照中,Fable 5.2 在 Xhigh 档拿到 49.1%,是这组对照中的最高分。截至 11 月 12 日,Artificial Analysis 综合能力榜上,Max 档以 65 分排第一,High 档为 62 分。
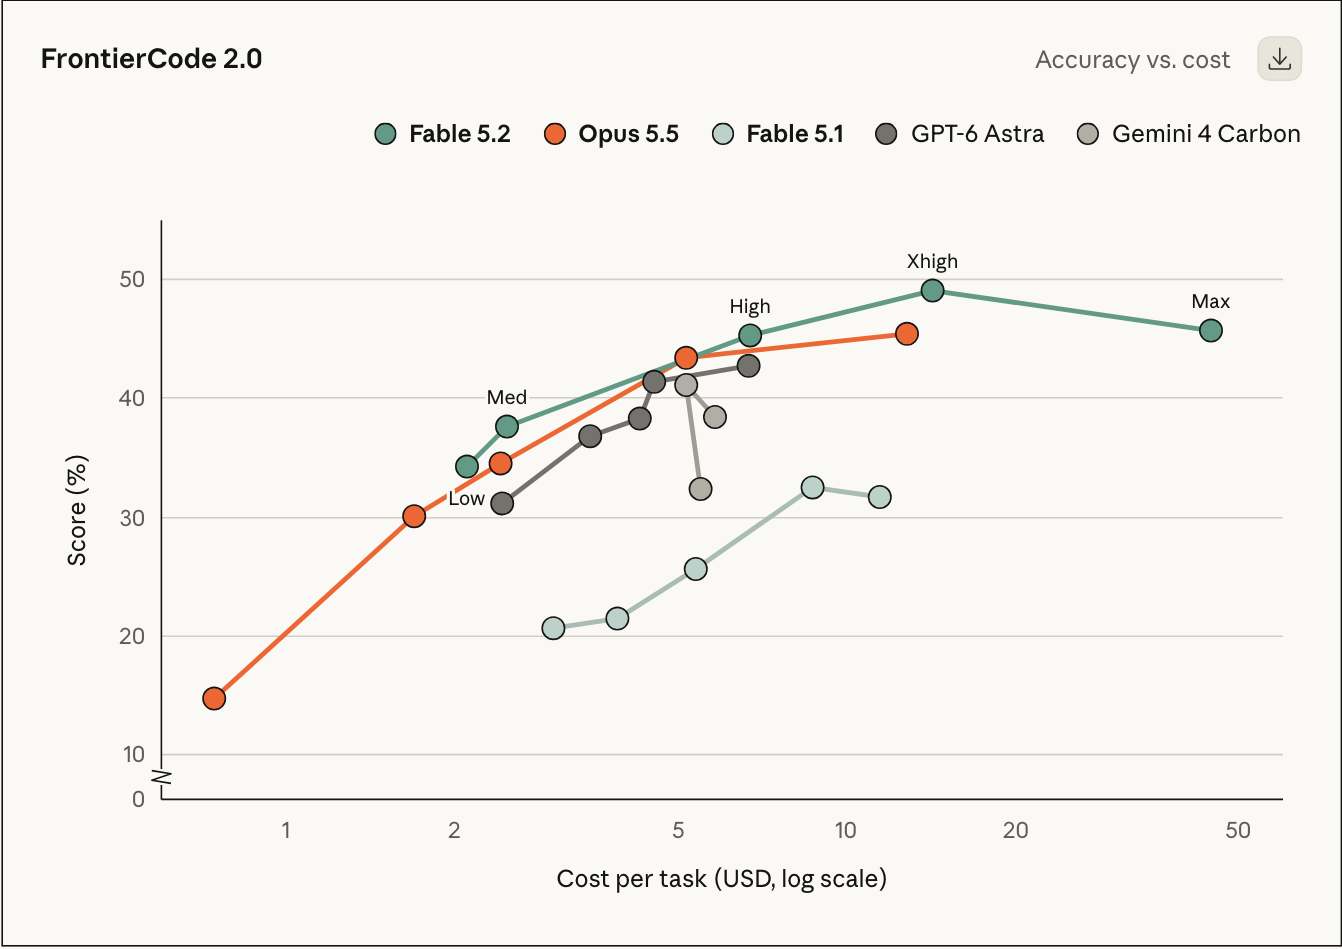
图为 Anthropic 的 FrontierCode 2.0 实测,横轴是单次任务成本,纵轴是得分。Claude Code 2.1.321 将 Fable 选项切到 5.2,通用默认模型仍是 Opus 5.5。Fable 5.2 API 每百万输入、输出 token 分别为 8 美元、40 美元。
Claude Mythos 5.2 与 Fable 5.2 共用基座,主要面向通过验证的网络安全和生命科学团队。在 Anthropic 用 1,829 个已公开漏洞做的 CVE Rediscovery 测试中,Mythos 5.2 在各推理档位均领先 Mythos 5.1 和 Opus 5.5,发布表给出的最高找回率为 89.6%。
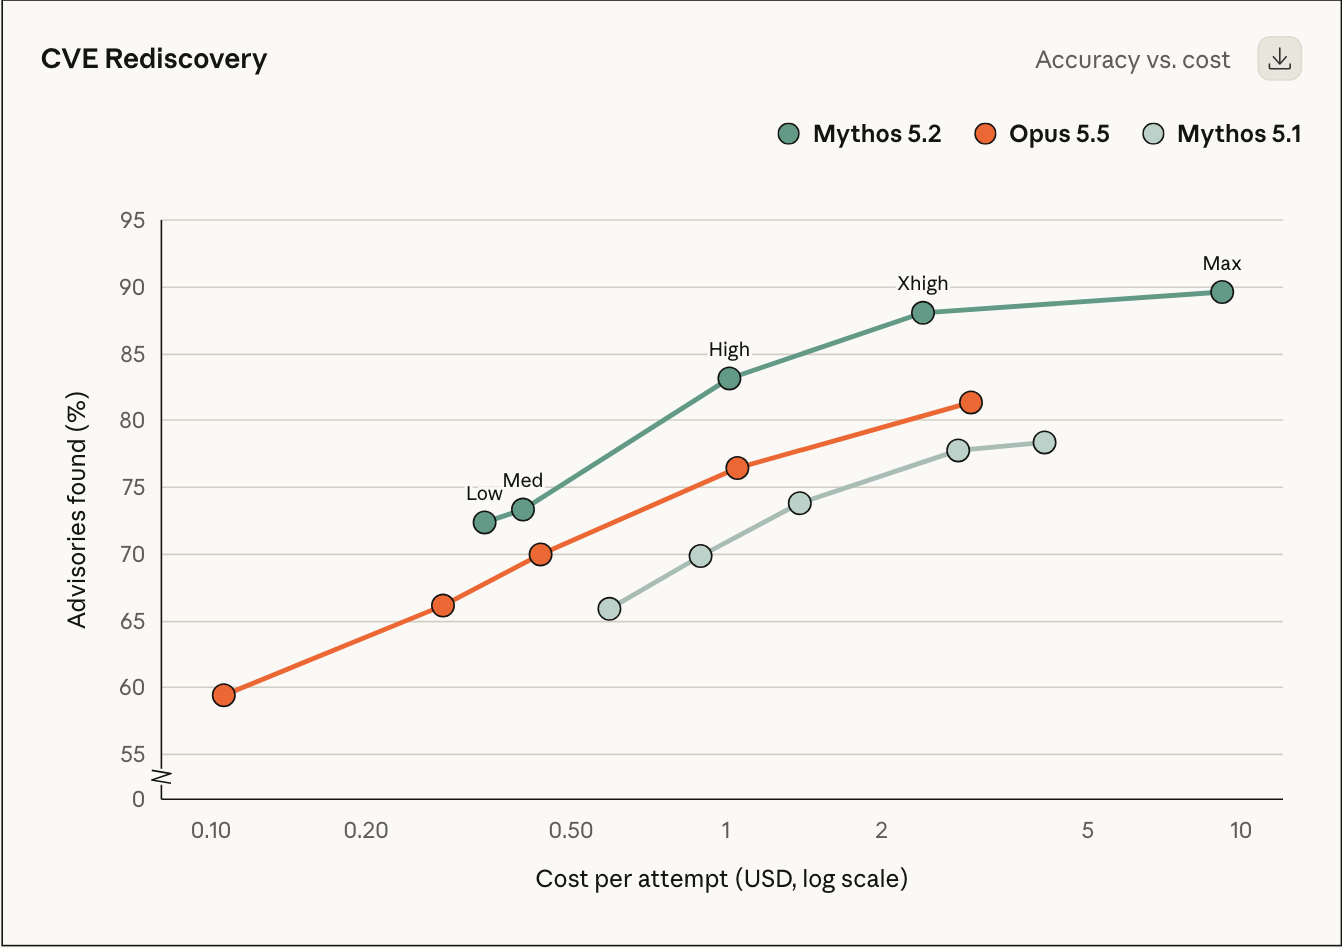
图为 Anthropic 内部测试,比较的是模型在修复前的项目快照中重新找到已知漏洞的能力。
Gemini 4 Carbon 从受限测试扩大到付费开发者和企业用户。Antigravity 的 /swarm 同步预览,Carbon 可以拆任务和做审查,执行任务的 Agent 在独立工作区工作。公开 API 的每百万 token 体验价为输入 2 美元、输出 10 美元,持续到 11 月 30 日,之后为 4 美元和 20 美元。
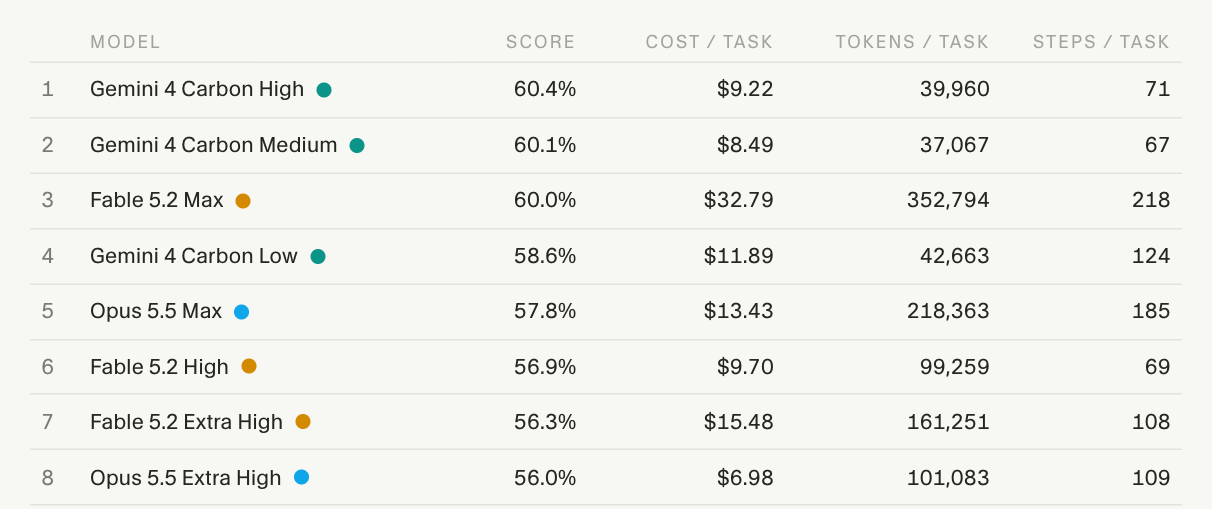
在 CursorBench 4.0 本期榜单快照中,Carbon High 以 60.4% 排第一,Carbon Medium 以 60.1% 排第二,Fable 5.2 Max 为 60.0%。Cursor 提醒,分数接近时,差异可能不具统计意义。
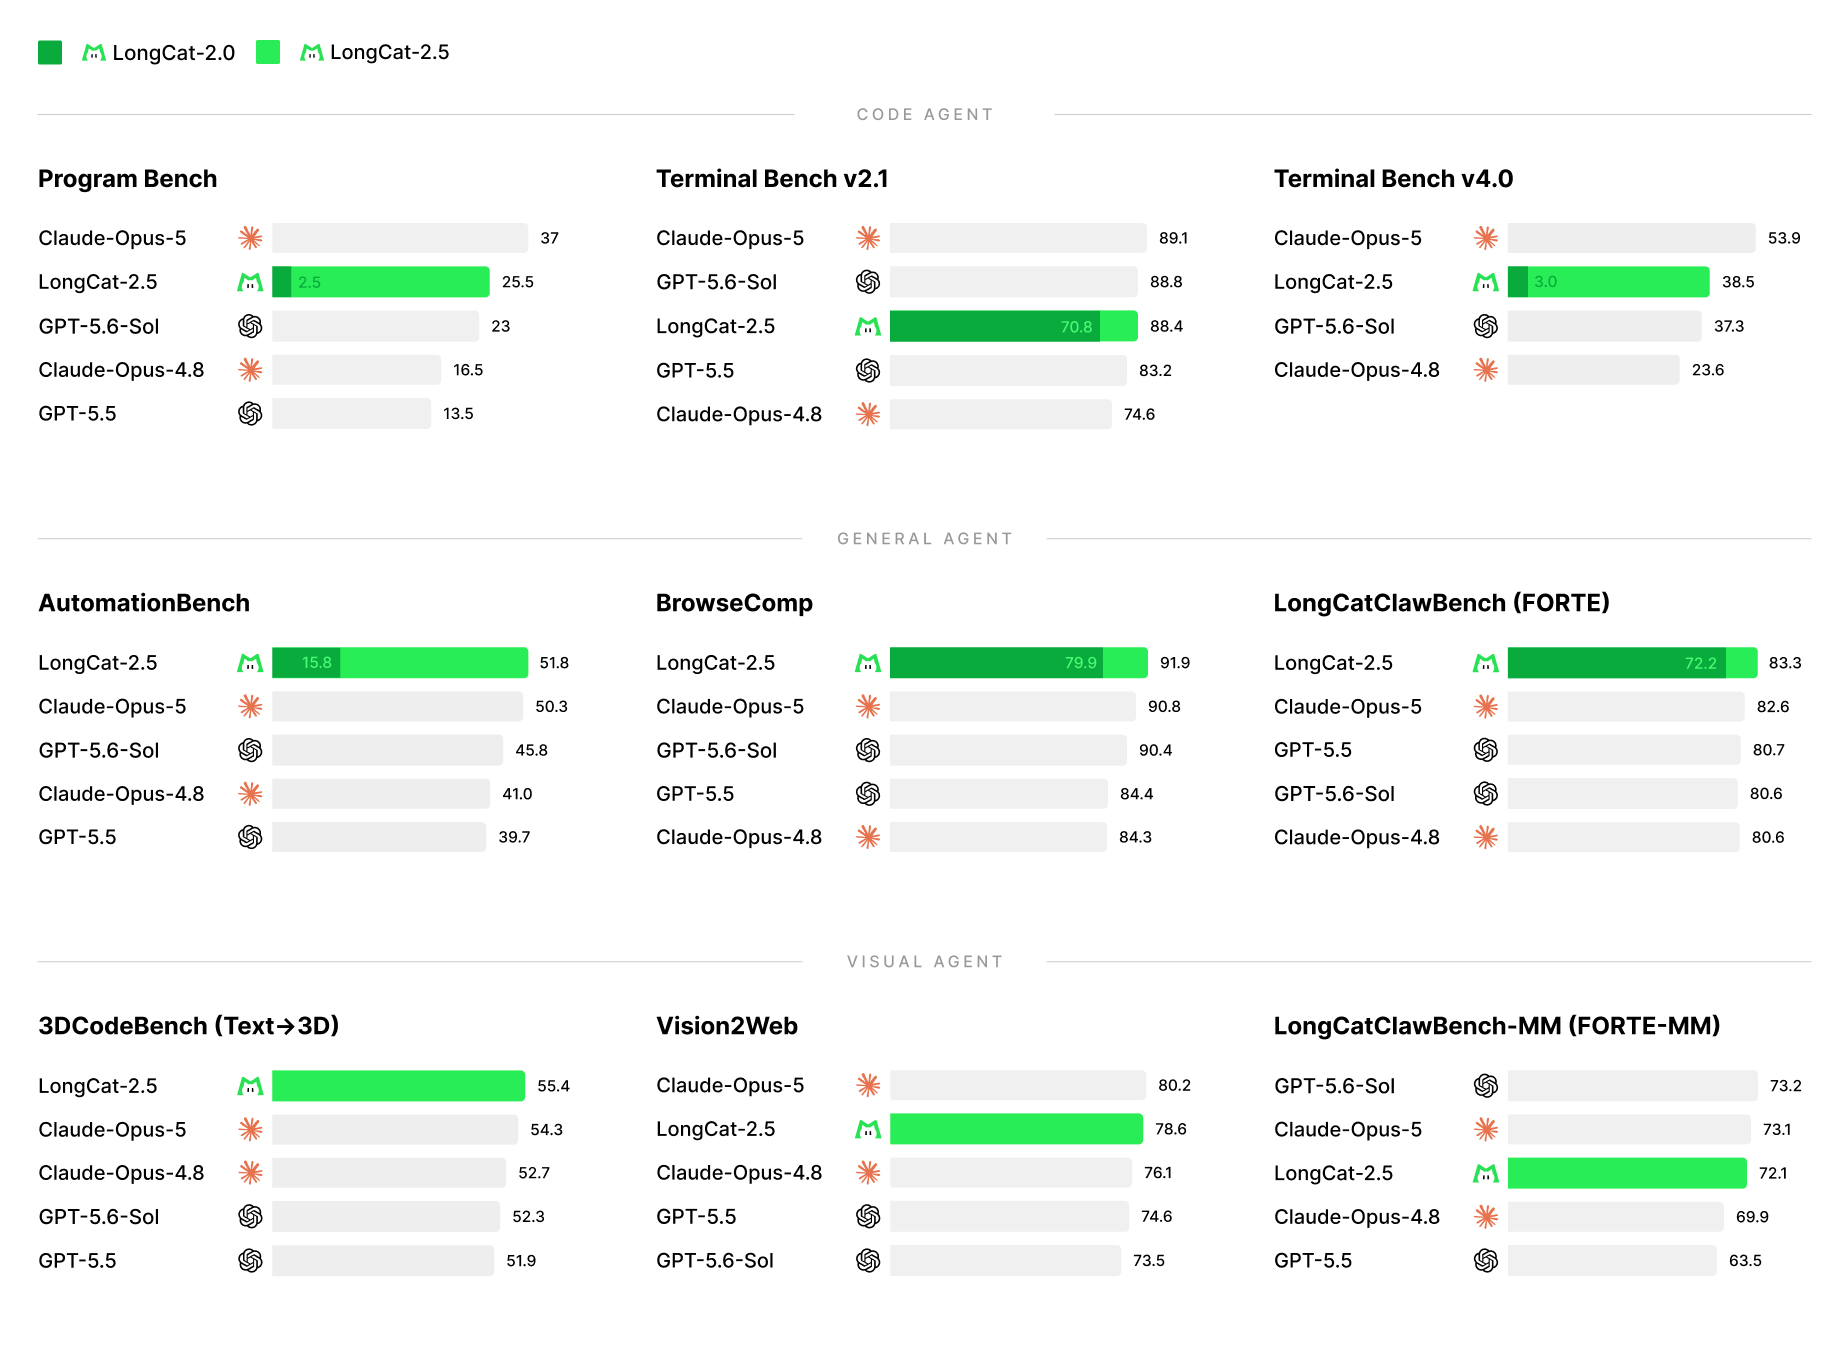
LongCat-2.5 本周开放权重,采用 MIT 许可。这是美团面向长程 Agent 任务的原生多模态模型,总参数 1.6T、激活参数 48B,支持 1M 上下文。美团的发布评测中,Terminal-Bench 4.0 得分 38.5,BrowseComp 得分 91.9。
Qwen4-Max-Preview 在阿里云百炼向 Token Plan 用户开放,支持多模态输入、推理和工具调用。上下文上限为 1M token,思考和最终回答共享 393,216 token 的输出预算。预览于北京时间 11 月 25 日 24:00 结束,随后下线。
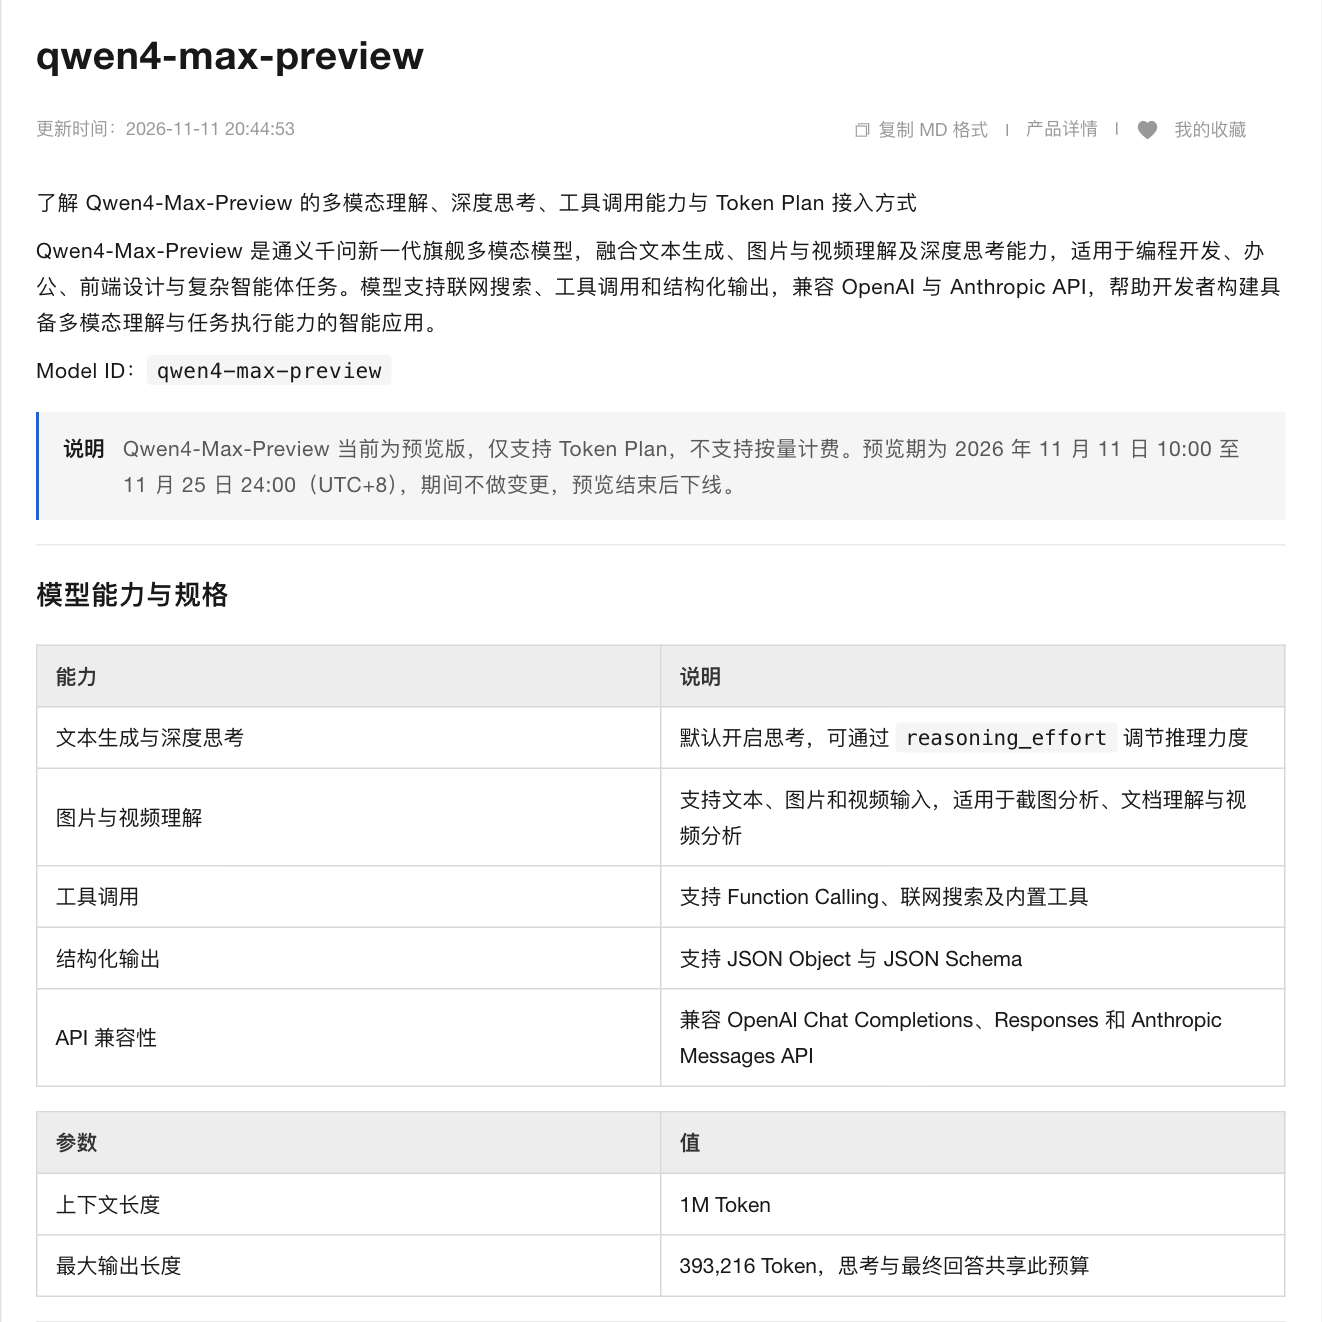
图为阿里云公开的能力规格。截至本期,Artificial Analysis 和 Text Arena 暂未收录这个预览版本。
文心 5.5 Flash Preview 已开放千帆 API,权重计划于 11 月 25 日前开放。这是此前 Base 模型的首个后训练版本,总参数 280B、激活参数 14B。百度公布的对照中,该版本在 Terminal-Bench 4.0 得到 46.5,DeepSWE v1.1 得到 71.2。
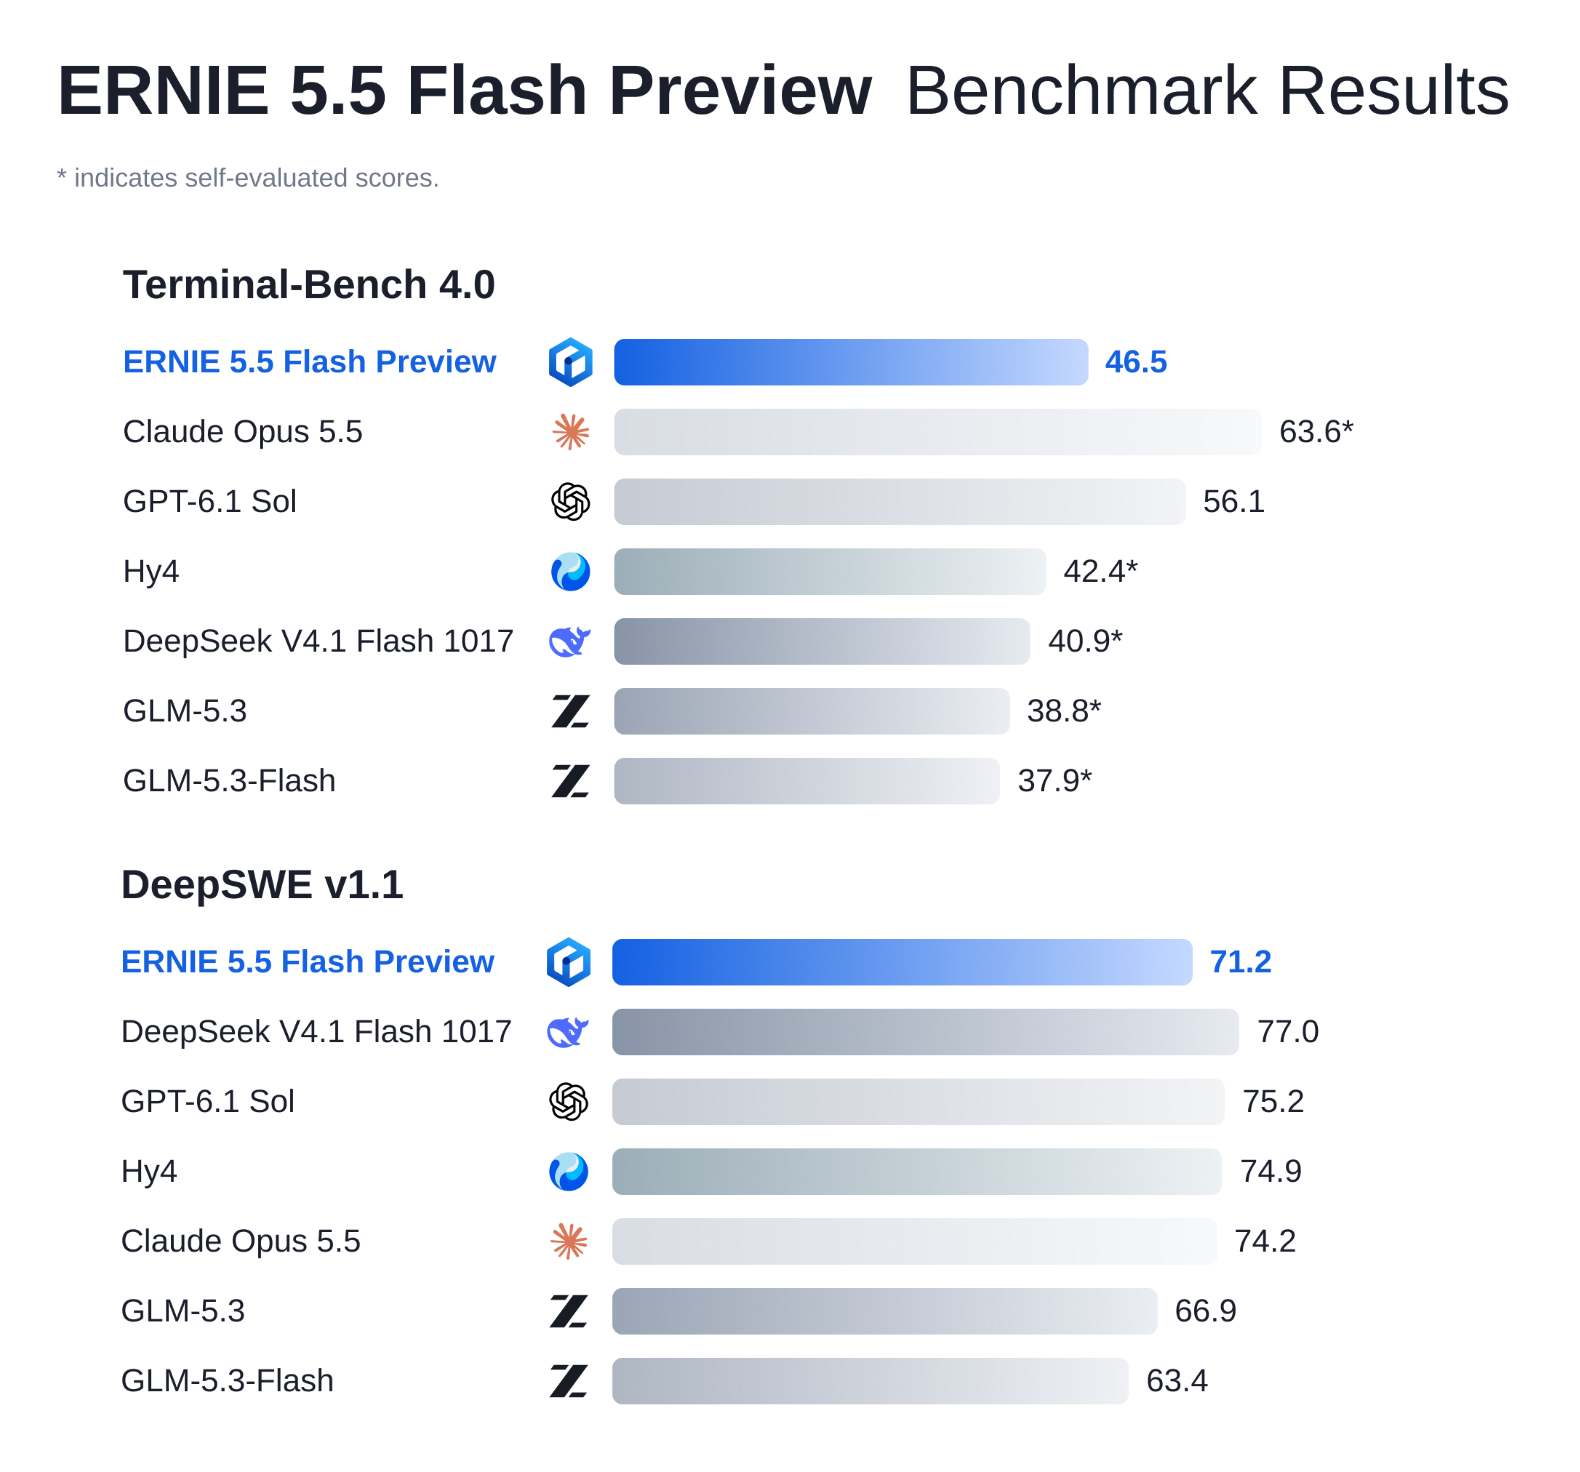
图为百度发布评测中两项编码测试的节选,星号表示自行评估的成绩。 百度完整评测图

Gemini Decision 1 随 Gemini Decisions API 开放。一份多模态输入可以带上最多 1,000 道封闭问题,模型一次前向传播就能返回候选概率,适合工具路由、标签分类和权限前置判断。Google 在最多 16K token 的上下文中测得端到端延迟为 150–250 毫秒。每次请求从 1 题增加到 100 题时,延迟近乎持平。
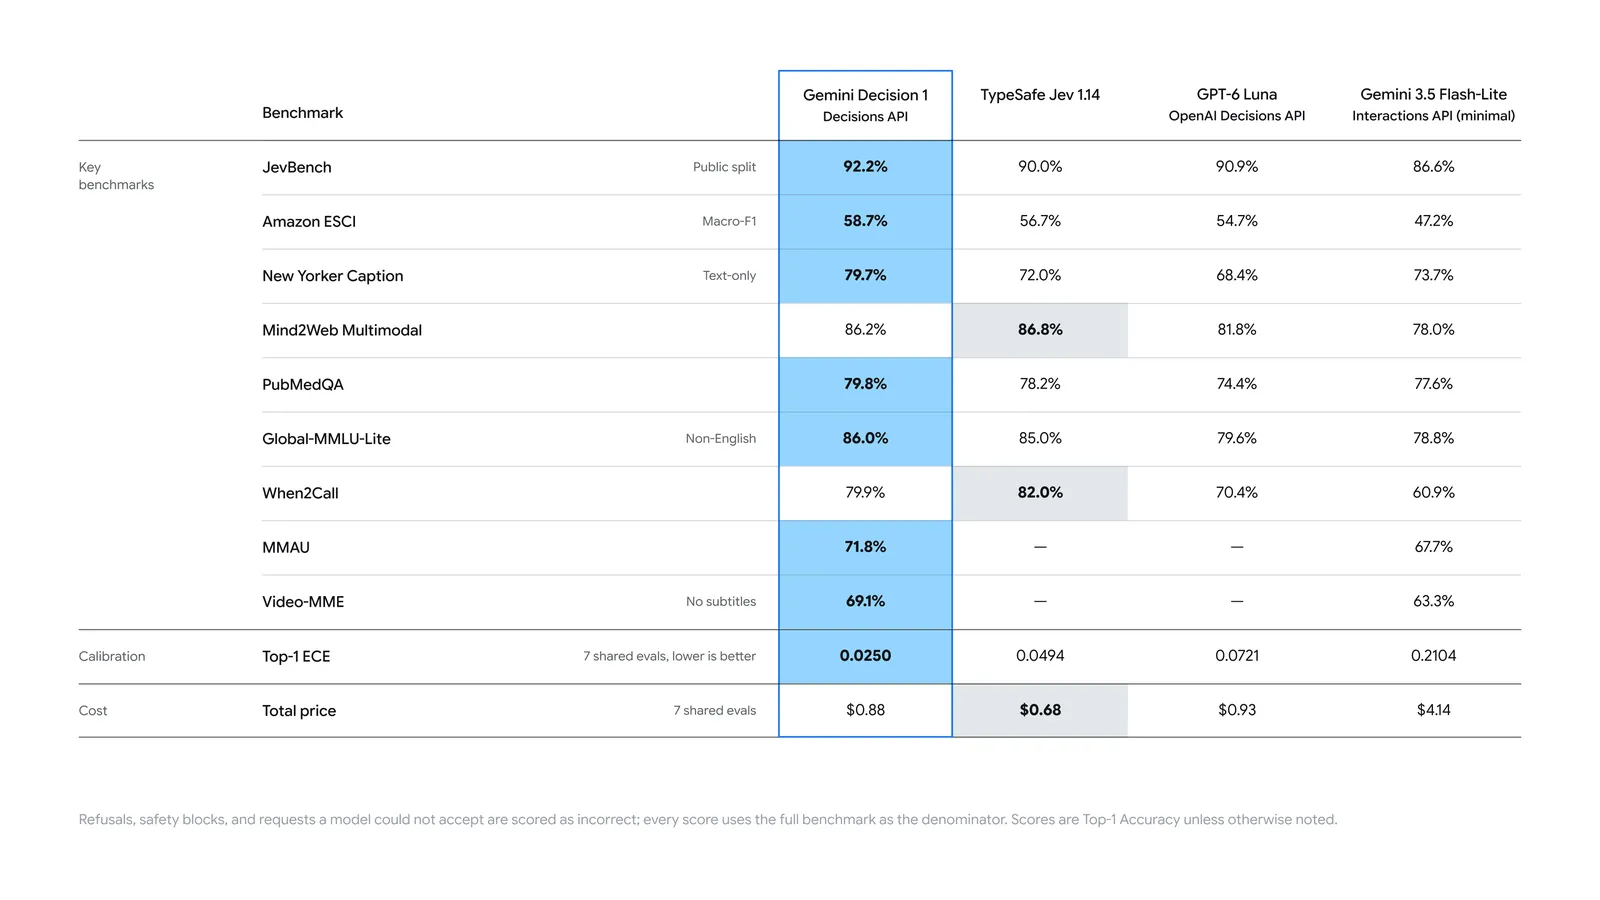
图为 Google 公布的分类与校准评测。在 Mind2Web 多模态任务中,Gemini Decision 1 得分 86.2%,同表的 TypeSafe Jev 1.14 为 86.8%。
📌 本周精选
AWS Emulator:Agent 写完代码,工程师怎么验收?
AWS 先让 Agent 写测试,再用真实服务校验测试本身。
Agent 根据公开的 Smithy API 模型写端到端测试。拿 SQS 来说,一条消息被某个消费者取走后,在可见性超时前,其他消费者应该读不到这条消息。Agent 先在真实 AWS 上跑通这个测试,再把同一个用例跑在模拟器上。真实服务通过、模拟器失败,就有了可以重跑的差异证据。
验证组把这些差异记成 issue,修复组逐个处理。工程师搭好测试环境和合并门禁,每个提交都要过编译、自动检查和多路安全审查。AWS 称模拟器代码全由 Agent 编写。
做接口迁移也可以用同一招。挑一份有代表性的请求,在新旧实现上各跑一次,比较返回值和关键副作用。发现差异时,把样例变成一个能重复运行的回归用例,再交给 Agent 修。合并后,这个用例还能继续验收下一轮迁移。
Addy Osmani:给 Coding Agent 的任务单该写什么
先写清怎么判断做完,再交代代码里查不到的背景。
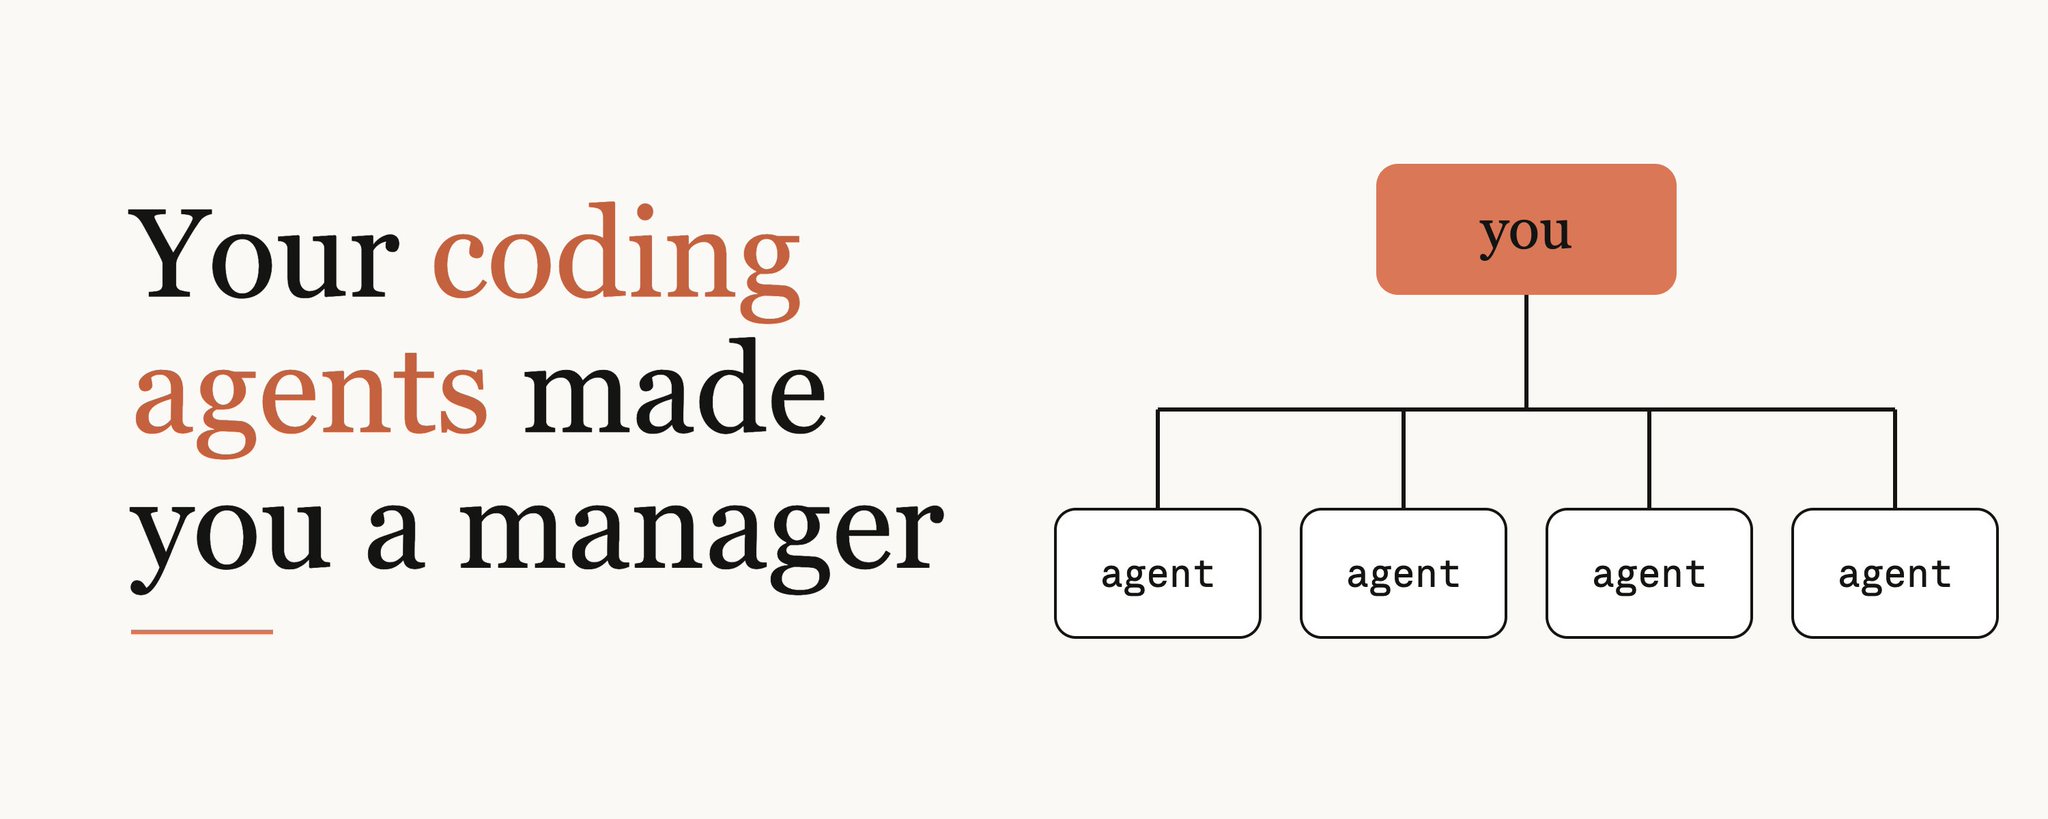
Addy Osmani 把任务交接拆成几个具体动作。给出目标、约束和成功标准,让 Agent 自己从仓库找到常规信息。跨文件或影响接口的任务可以先过一遍计划,交付时要求贴出测试、构建或截图。独立审查可以另开一个没有参与实现的会话,直接看 diff 和验收证据。
他也给了一个判断该写规则还是继续改提示的办法。同一种错误被纠正两次,就找出它为何会重复。仓库约定可以写进 CLAUDE.md,重复流程可以做成 skill,必须执行的检查可以放到 hook 或 CI。工程师仍要决定这份改动是否可合并。
Anthropic 的 Agent 记忆实验:什么值得带进下一个会话?
把可追溯的记录和可复用的规则分开保存。
Anthropic 把记忆分成会话记录、Agent 写下的笔记、Wiki,以及每次启动时注入的上下文。会话间可以再运行一次整理,让 Agent 从日志里提取经验、修正旧笔记。研究里的数据库问答任务显示,效果较好的模型会把猜测和已验证的规则分开,还会记下当初用什么检查验证过。
在一组针对企业文档的 25 道题里,单独搜索覆盖了 53% 的评分项。加上经过 128 个会话迭代的 Wiki 后,覆盖率达到 61%。套到代码库,原始日志可以留给追溯,交接笔记记录结论及其来源,只有稳定、反复会用到的规则才放进每次都要读的项目指令。
Curative 的合同 Agent:哪些动作要交给别人审核?
每条外发消息先过审,超出标准费率的报价另走审批。
Curative 的 Gwen 每次负责一家医疗服务机构,从外联跟到签字。据团队披露,Gwen 参与签署了约 2.3 万份合同。主 Agent 用 Opus 处理谈判,超出标准费率的申请交给 Sonnet 初审,仍需判断的价格再转人工。有一次 Gwen 把内部能接受的最高费率写进了对外消息,团队随后加入 Haiku 审核所有外发内容。消息被拦后,Gwen 会拿到理由并重写。
这种拆法适合用在会发邮件、改权限或更新生产数据的工具上。先列出哪些动作需要通过检查,再决定由规则、模型还是人来核准。一次内部检索和一次对外发送,可以有不同的审核成本。
Google A2UI 1.0:让用户在界面里确认 Agent 的方案
把一轮需要来回确认的对话,做成一张可编辑的表单。
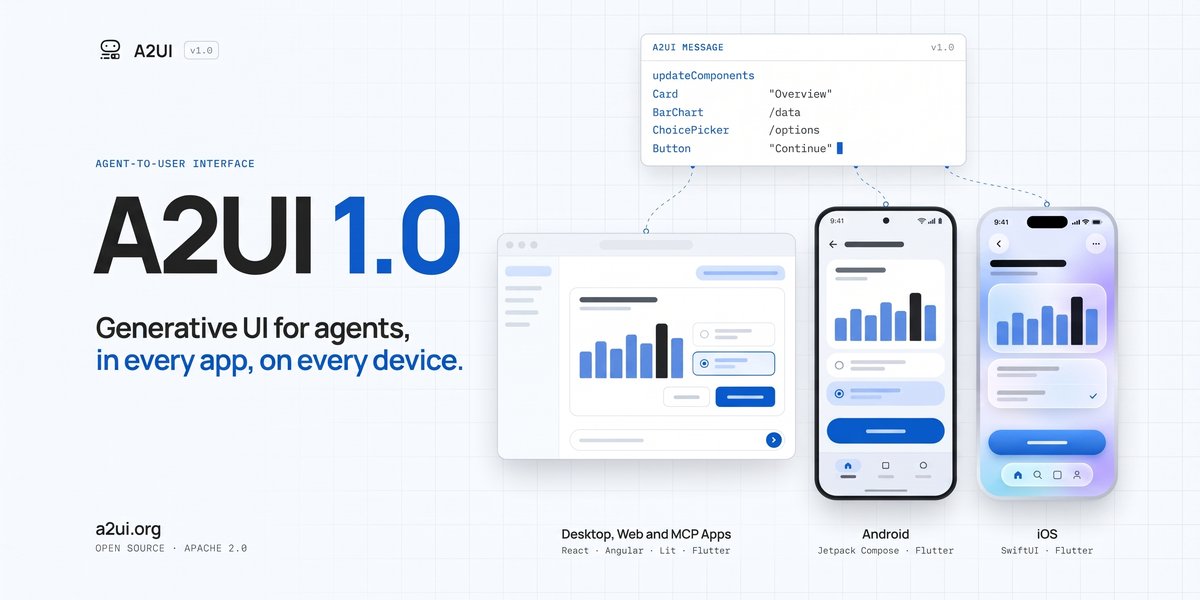
A2UI 的 Agent 输出一份界面描述,客户端用开发者注册的组件绘制表单、图表或确认界面。1.0 新增双向函数调用,用户在预订组件里改日期时,应用可以立即查询最新可用选项。Google 提供 Web 和移动端渲染 SDK。Android 的 Jetpack Compose 渲染器仍是 0.9.1,1.0 待发布。也可以先在 Playground 试验组件组合。
一个适合起步的场景是批量改期。把 Agent 提出的时间和冲突放进同一张表,让用户只改有问题的几项,再显式确认提交。工具仍由应用调用,Agent 负责提出方案和组织呈现。
💬 社区热议
Fable 5.2 单价降了,为什么有人说跑一题更贵?
Reddit 原帖用 Artificial Analysis 的综合评测比较两代 Fable 的 Max 档。Fable 5.2 在这组任务上平均每题花 26.54 美元,Fable 5.1 为 12.99 美元。每百万 token 的单价降了,同档跑完一道评测任务的费用却约翻倍。
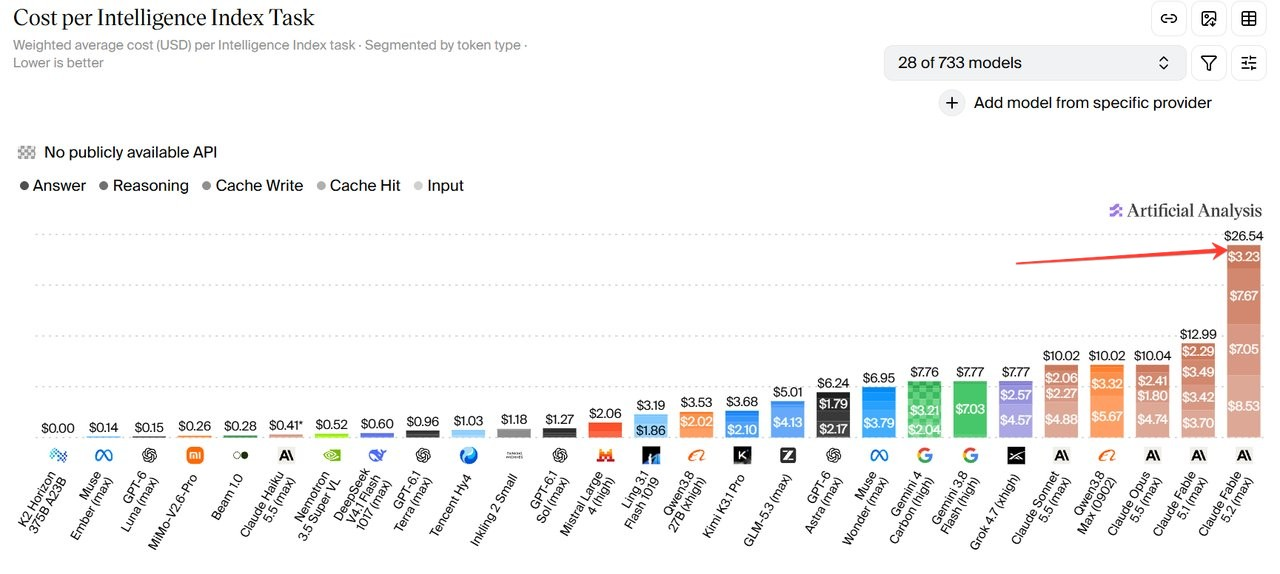
再看 同一套 Artificial Analysis 评测的 11 月 12 日榜单。Fable 5.2 High 拿到 62 分,平均每题 9.08 美元。Max 是 65 分,单题成本接近 High 的 3 倍。给仓库选默认档位时,可以先用 High 跑几道常做的任务,再把没过验收的用例交给 Max,看看多花的时间和用量能解决哪些问题。
Matt Pocock 用一个 Home Repo 管多个代码库
Matt 把常用 skills、规则和 Wiki 放进一个 Home Repo,平时从这里启动 Agent,并在 AGENTS.md 中标明各个代码库的本机路径。适合试这套办法的是经常跨应用、服务和文档仓库改同一件事的人。各仓库自己的构建命令和约定继续由对应项目维护,入口仓库只需要说明去哪里找。
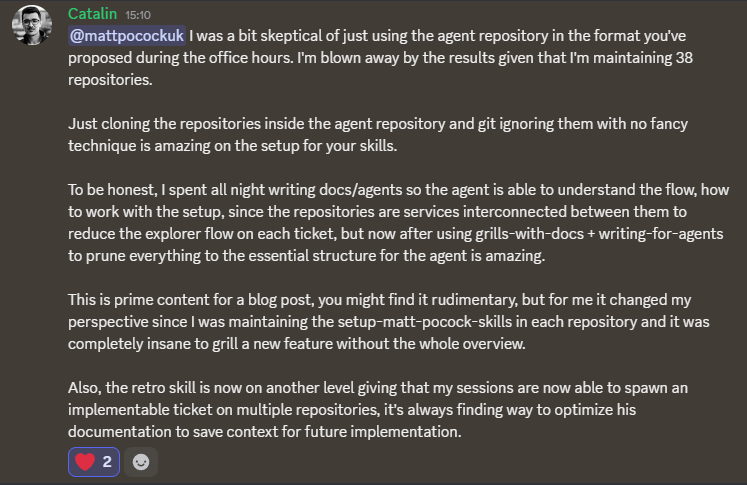
Matt 在原帖附了一位维护 38 个仓库的读者反馈。对方把项目克隆到入口目录并用 Git 忽略这些子目录,仍花了一整晚补齐跨仓库文档。图里能看到统一入口背后还有哪些整理工作。
美国软件工程师入职放缓,全球 FDE 招聘职位增多
Lenny Rachitsky 的报告把公开职位和实际入职分开统计。2025 年 5 月至 2026 年 4 月,美国约有 11.3 万名软件工程师入职,低于 2022 年约 23.9 万的峰值。全球 Forward Deployed Engineer(FDE)的公开职位约为上年同期的 4.6 倍。原报告提到,增幅可能有一部分来自销售工程师等职位改用 FDE 头衔。
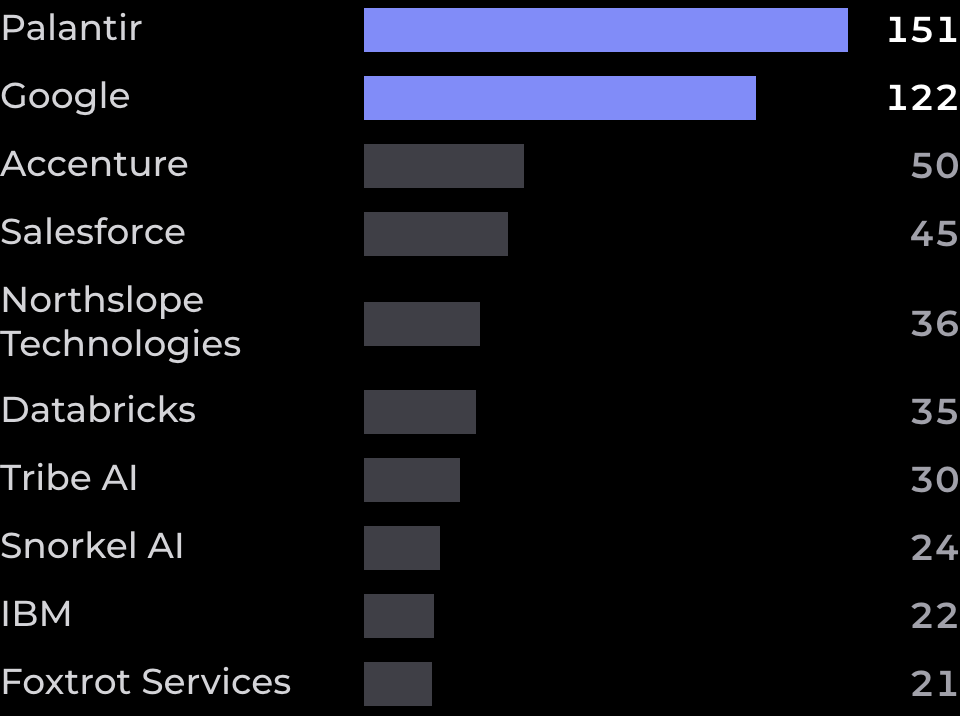
图源为 Live Data Technologies,统计 2026 年 1 月 1 日至 11 月 6 日在美国从其他雇主入职的 FDE 人数。Palantir 记录到 151 人,Google 122 人,最近月份仍在补录。
🧩 开源社区
milind-soni/OpenMausBot
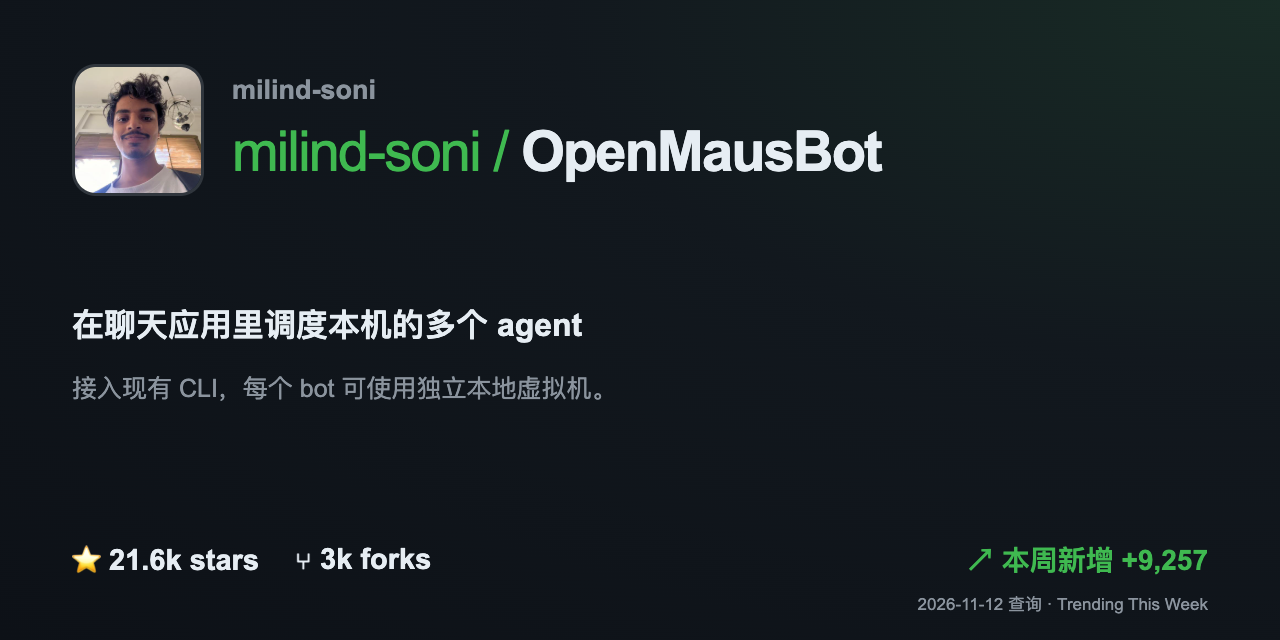
OpenMausBot 把本机的 Claude Code、Codex 等 CLI 变成聊天联系人。后台服务负责启动 CLI,再把工具执行、回复和审批请求发到聊天窗口。每个 Bot 可以单独配模型、指令和工具,也能分配独立的本地虚拟机。需要确认的 Shell 命令或文件修改会以卡片出现在会话里。
v0.1.154 让单聊和群聊都能流式显示回复,也给用官方一键安装器搭建的自托管服务器加了应用内更新,升级前会备份。可以从 Releases 下载桌面端,接入已经登录的 Codex,先建一个只负责读 diff 的 Bot,在测试仓库里走一遍请求和审批流程。
vercel-labs/agent-browser
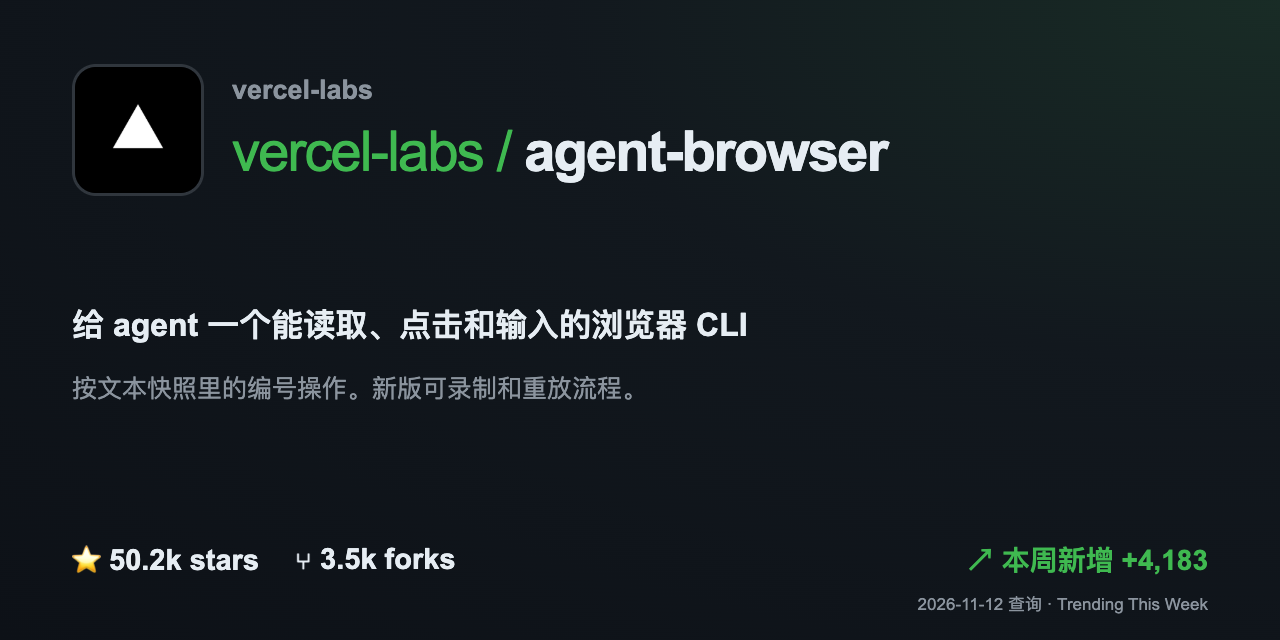
agent-browser 是给 Agent 用的 Rust CLI。浏览器在后台保持打开,snapshot -i 会列出按钮、输入框等可交互元素及其编号。Agent 点完按钮或提交表单后,再取一次快照就能检查结果。跳转或 DOM 变化后要刷新快照,编号只对应上一次读取的页面状态。
v0.42.0 加了实验性的任务录制。重跑时依次尝试直接发 HTTP 请求、在网页内发请求、按录下的浏览器命令操作,并记住成功的方式。这个功能只向公网地址发请求。可以在 Node.js 22 或以上环境用 npm install -g agent-browser 安装,再运行 agent-browser install 下载浏览器,先拿预发布站点上的搜索流程试手。
zed-industries/zed
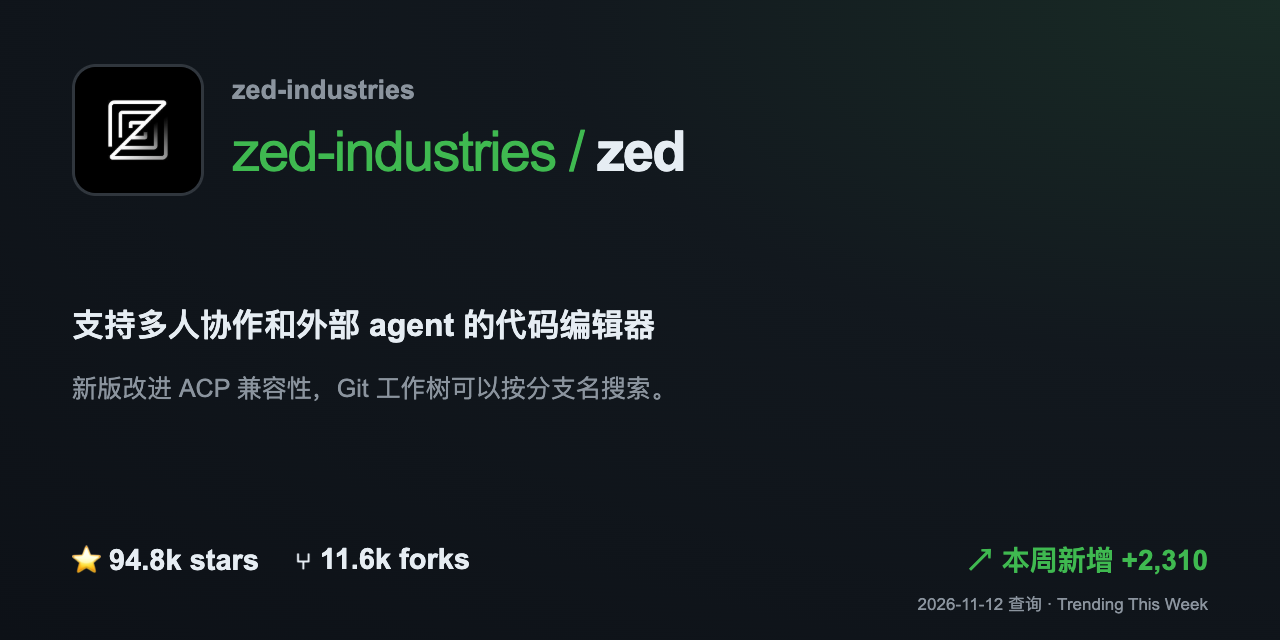
Zed 把外部 Agent 接进编辑器的会话面板,自己负责展示计划、代码差异和权限请求,模型和登录则由外部 Agent 管理。从 ACP Registry 安装 Codex 或 Claude Agent 后,就能直接开会话。两个任务可能改到同一文件时,可以把它们放在不同的 Git worktree,完成后再分别看 diff。
v1.28.1 改善了外部会话丢失、计划更新、diff 格式和权限请求取消的处理,也支持在 worktree 选择器里按分支名搜索。第一次试并行会话,可以一边补测试,一边在另一个 worktree 查失败原因。Zed 新建的 worktree 默认处于 detached HEAD,准备保留提交时先建分支。
deepseek-ai/deepseek-harness
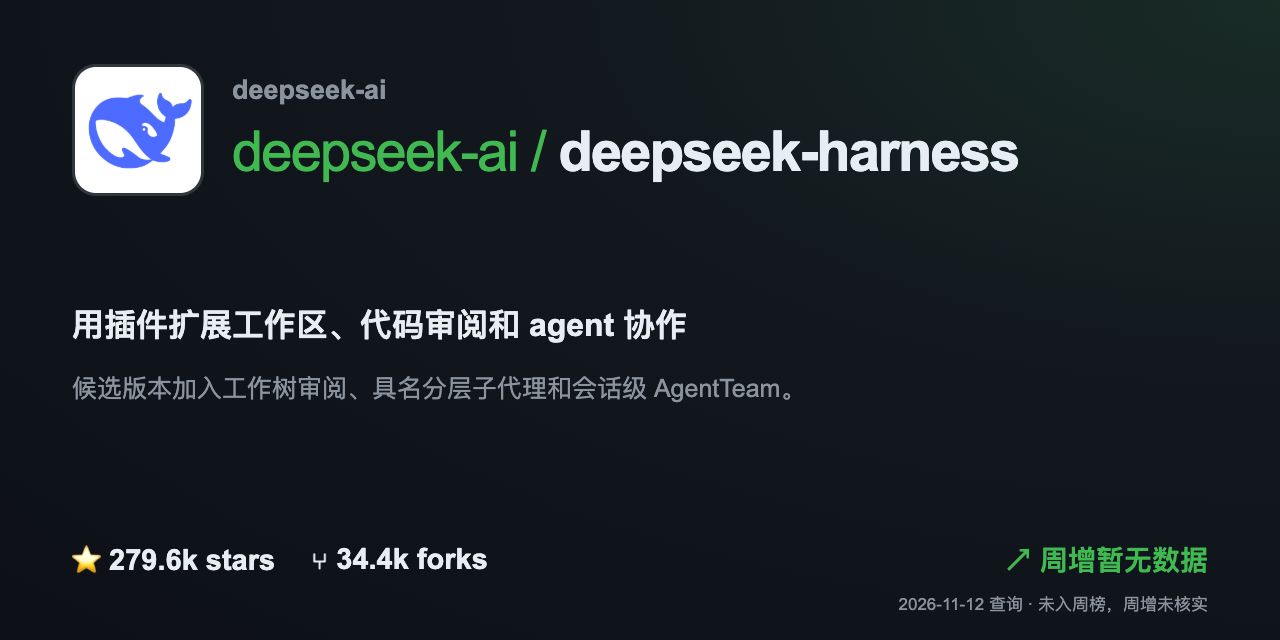
DeepSeek Harness 用插件组织工具、界面和 Agent 能力。这次的 v0.2.2-rc.2 给子代理加了名字和分层协作,AgentTeam 也可以按会话开启,用同一面板看成员和任务。Worktree 审阅能按分支、提交或文件类型筛改动,还能处理 GitHub 评审并同步已审阅进度。
可以用 npx @deepseek-ai/dsh@0.2.2-rc.2 web 在本机试候选版。挑一个同时改实现和测试的分支,先按文件类型逐组审阅,再切到单个提交核对修改。这个版本归档会话时默认清理符合条件的 worktree,分支和提交仍保留。需要保留工作目录时,可以先关掉自动清理。
✉️ 关于周报
本周报的内容来自一套我自己打磨出的自动化采集工具。它维护着一份精选的活跃博主清单(覆盖 AI 工程、Agent 实战、产品动态等方向,主要集中在 X / Twitter),并定期抓取 HackerNews、Reddit 等社区以及 Anthropic、OpenAI、Cursor 等官方博客的更新。
每天采集一次,每条内容会按「洞见性、独特性、深挖价值」三个维度打分排序,算法筛出高分候选内容。周报会汇总近 7 天内容,再经过人工去重、剔除和把关,最终汇编成你看到的这期周报。整套流程是机器采集加人工筛选的结果。
完整归档与历史期数见 GitHub 仓库
欢迎关注公众号「AGI成长之路」,后台点击进群交流,一起学习更多 AI 知识。